三种 seq2seq 结构(seq2seq 演变)
一句话
seq2seq 的演进主线:从「整句压成一个语义向量」到「Decoder 每一步按需回看 Encoder 的不同位置」,这正是注意力机制的由来,也是 Transformer 的前身。
1. 无注意力(Vanilla Seq2Seq)
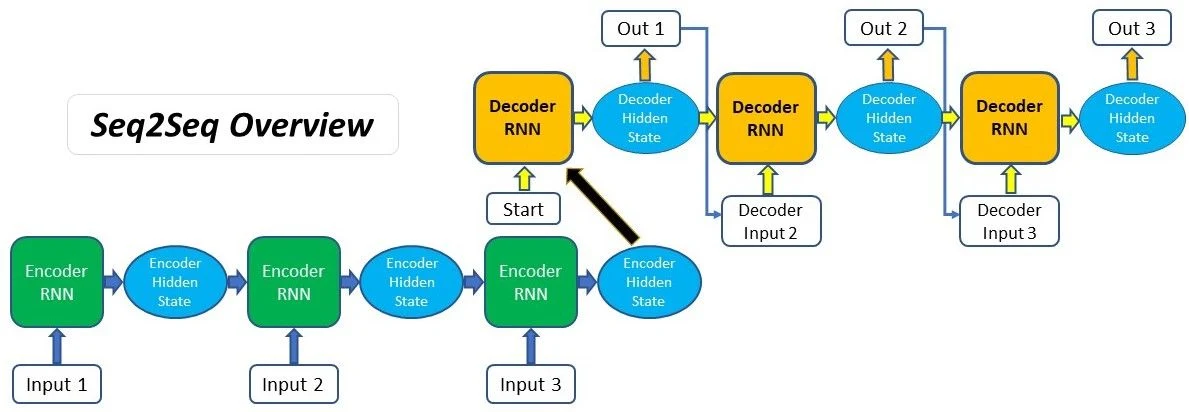
Encoder 把整句压缩成最后一个隐状态作为语义向量 C,Decoder 每一步都只基于这个固定向量生成。
瓶颈
句子越长,固定长度的
C越装不下全部信息,长距离依赖容易丢失——这是后来加注意力的直接动因。
2. Bahdanau attention(加性注意力)
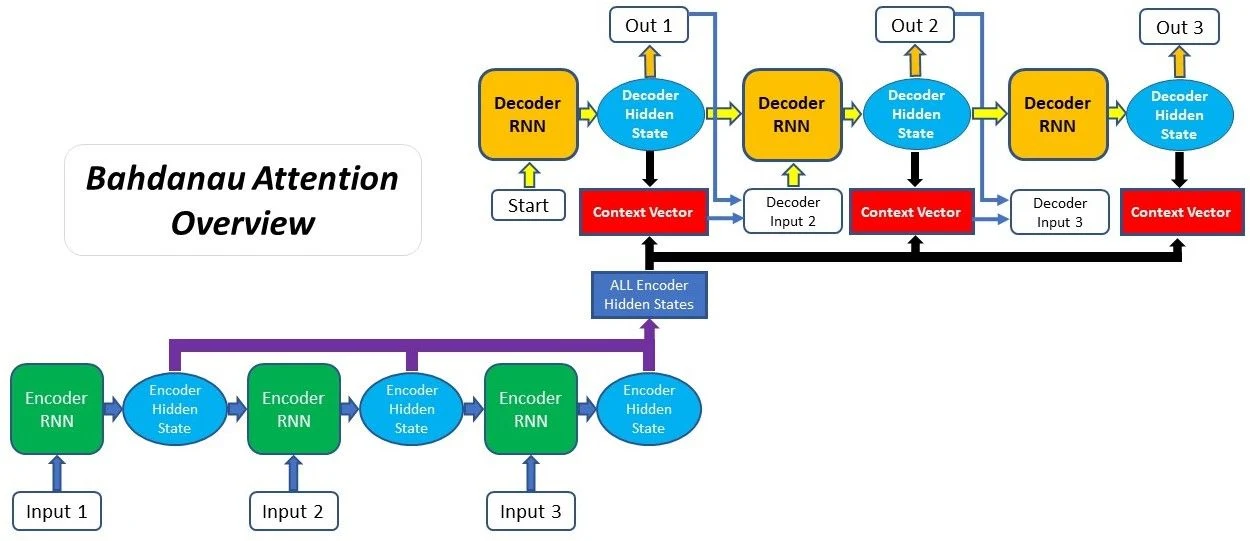
Decoder 在第 t 步生成时,拿自己的隐状态去和 Encoder 每个位置的隐状态计算打分(tanh 加性打分),softmax 得到权重后做加权求和,得到这一步专属的上下文向量 c_t。
- 特点:双向 RNN + 加性(additive)对齐
- 收益:不再依赖单一向量,长句翻译质量明显提升
3. Luong attention(乘性注意力)
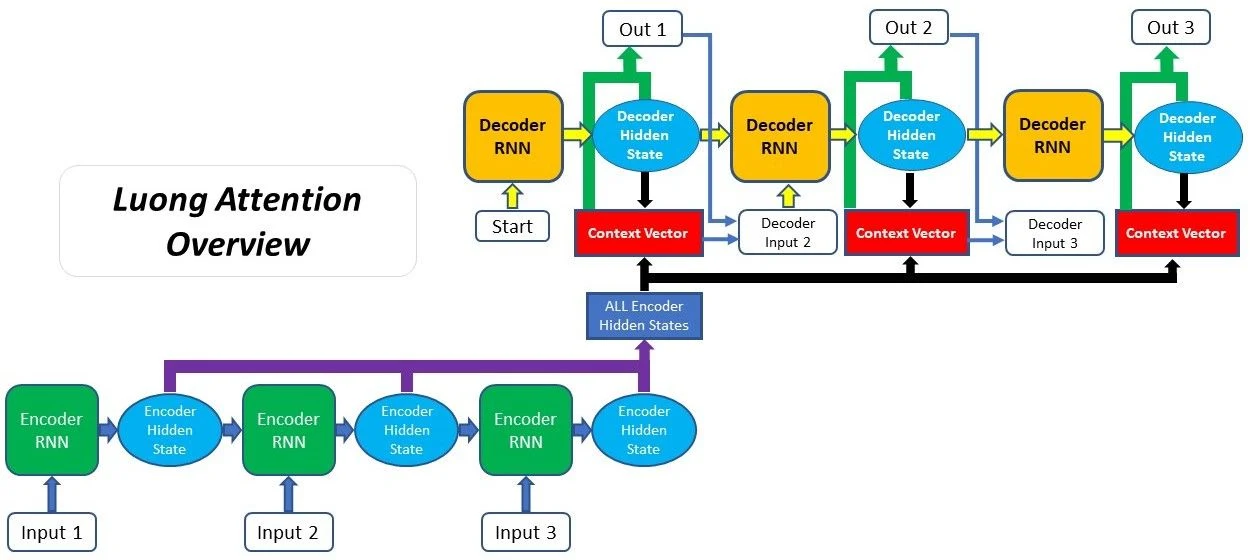
Luong 把 Bahdanau 的加性打分换成点积/双线性(multiplicative)形式,并把注意力计算放在 Decoder 输出之后。
- 特点:单向 RNN + 乘性(multiplicative)对齐,计算更快、更省
- 对比:结构更简洁,效果相当,后续 Transformer 的 QKV 点积注意力即由此发展而来
对比速查
| 结构 | 打分方式 | 上下文向量 | 主要问题 / 收益 |
|---|---|---|---|
| 无注意力 | — | 全局固定 C | 长句信息瓶颈 |
| Bahdanau | 加性(tanh) | 每步动态 c_t | 缓解长依赖,双向 RNN 较慢 |
| Luong | 乘性(点积) | 每步动态 c_t | 更快更简洁,走向点积注意力 |
交互式图解
内嵌对比图(含公式推导,可交互查看三种结构的差异):
相关笔记
- 从seq2seq到attention — seq2seq 到注意力机制的完整原理讲解
- transformer架构和自注意力机制 — 点积注意力 / 自注意力的现代形态
- LLM 与 Transformer 底层原理与架构演进总纲 — 架构演进总览