LLM 与 Transformer 底层原理与架构演进总纲
一句话总结
把 4 份资料(两份 PDF + 两张进化图解)整合成一张「原理 → 演进 → 训练 → 生态 → 前沿」的完整地图。核心两条主线:① 从第一性原理看透 Transformer——大模型内核永远只是「输入 → 转换 → 输出」
y=f(x),即”给定前面的词预测下一个词”;② 从演化学视角看架构史——统计计数 → 词向量 → 记忆网络 → 注意力/Transformer,每一代都在解决上一代的致命缺陷、又暴露新问题。
本表图集(可直接点击查看原图)
下面的两张图与两份 PDF 配套,速览用:第一张是演进时间线,第二张是底层逻辑全景。
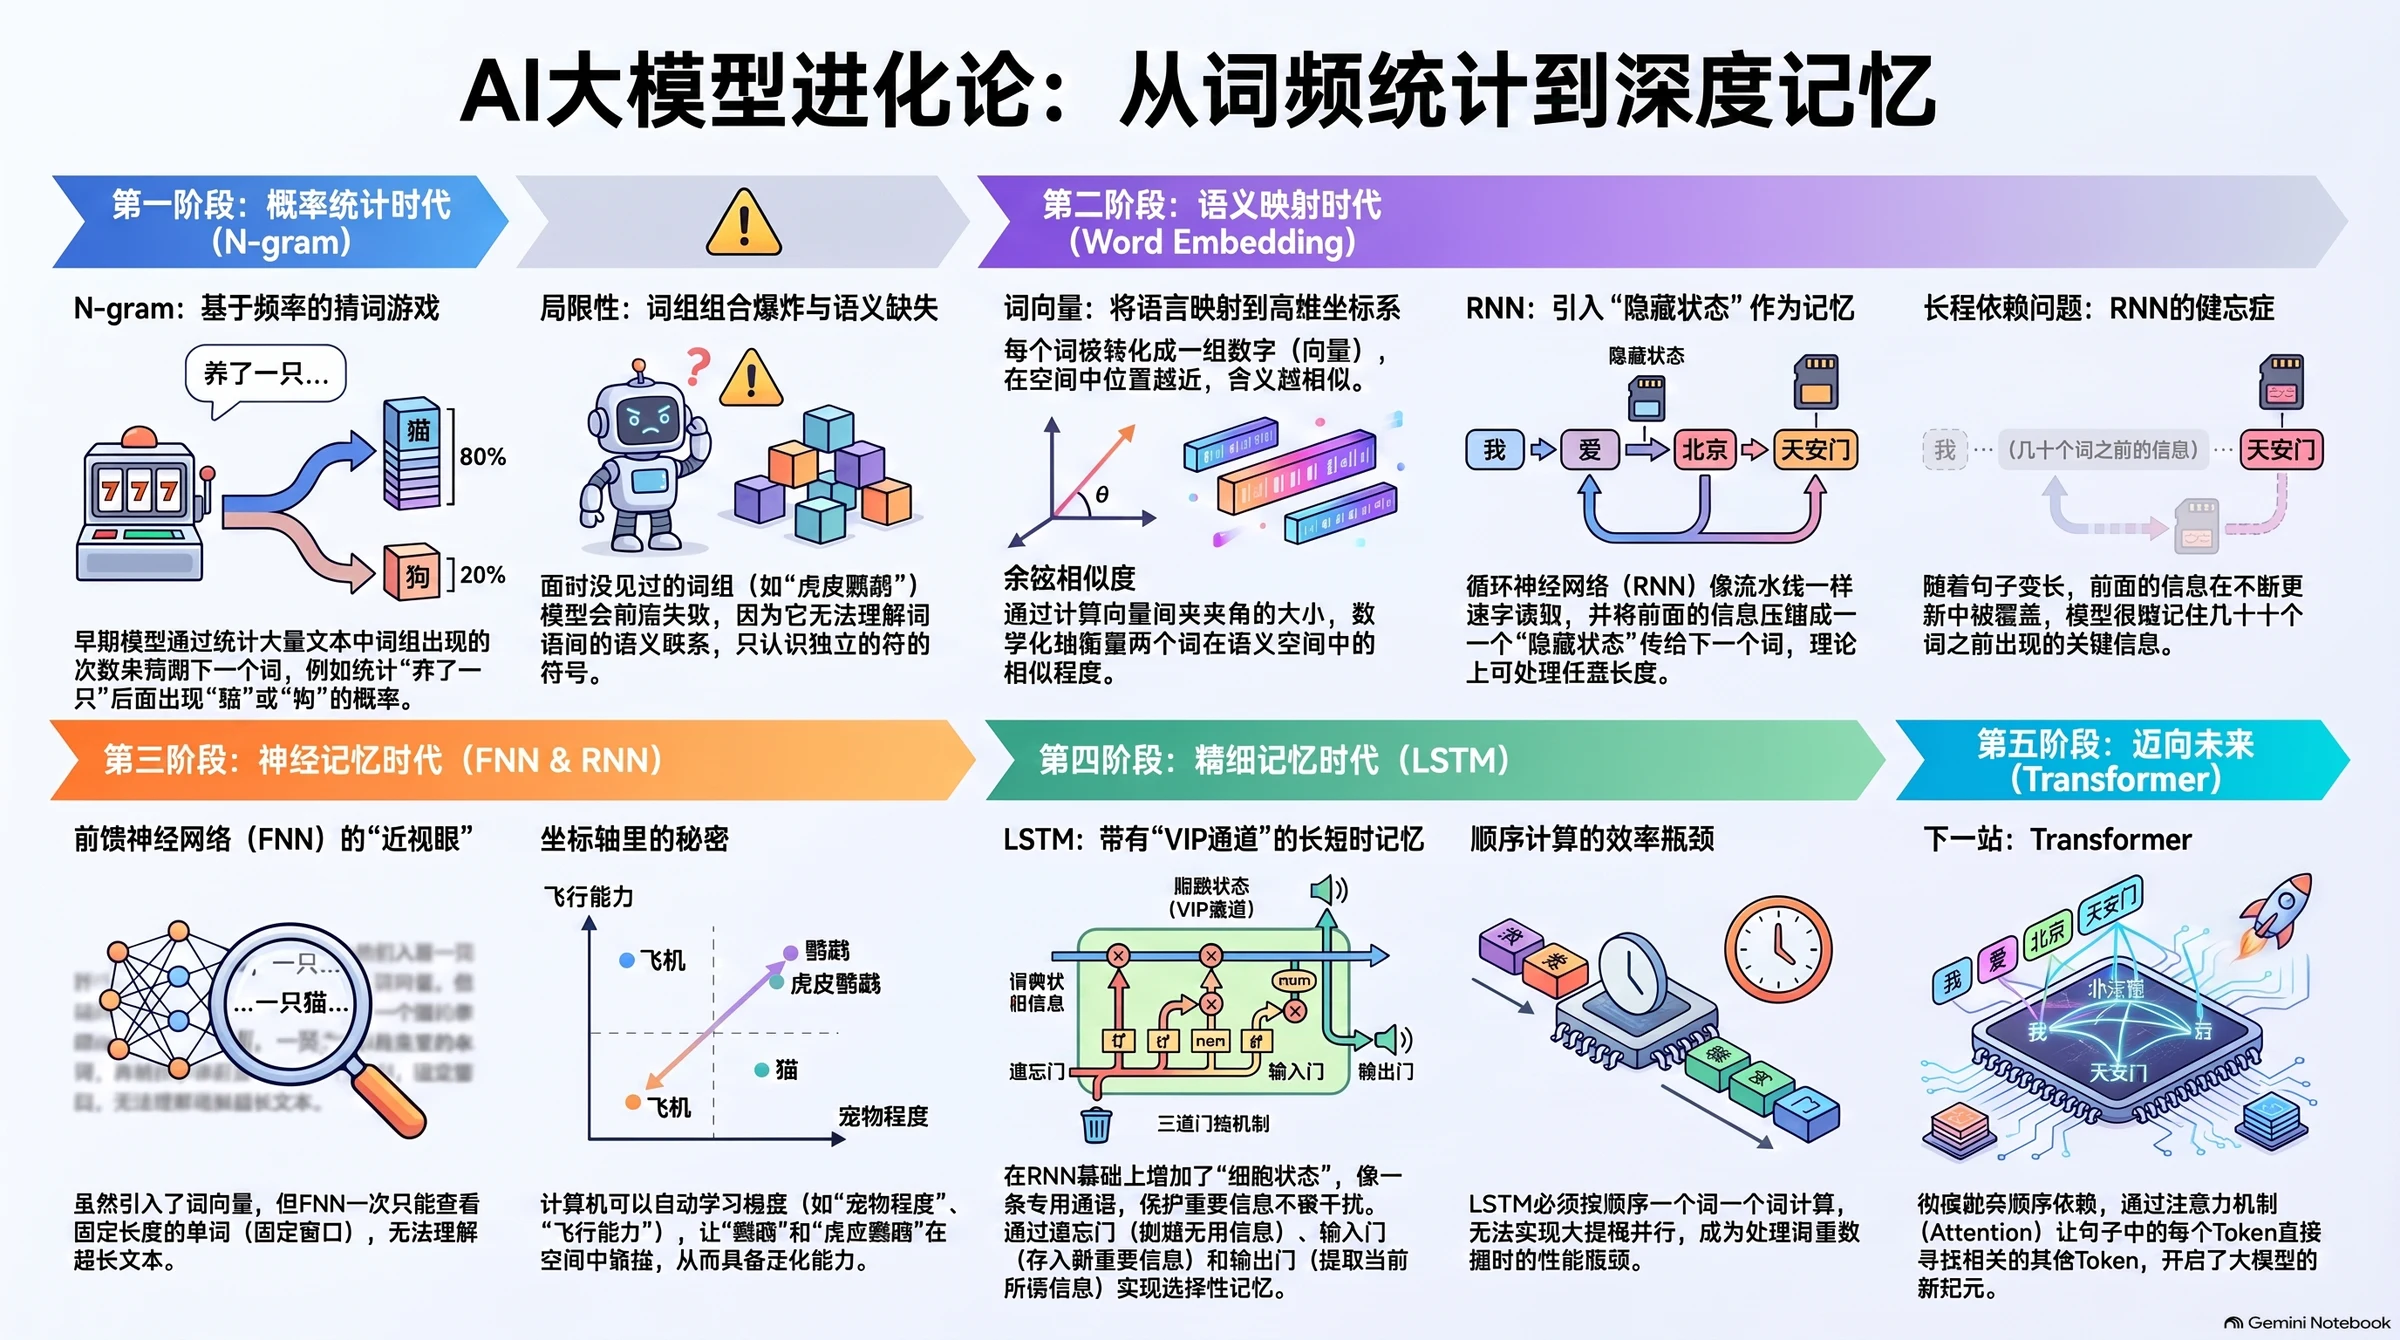
▲ 图1|AI 大模型进化历程图解(从词频统计到深度记忆:N-gram → 词向量 → FNN/RNN → LSTM → Transformer)
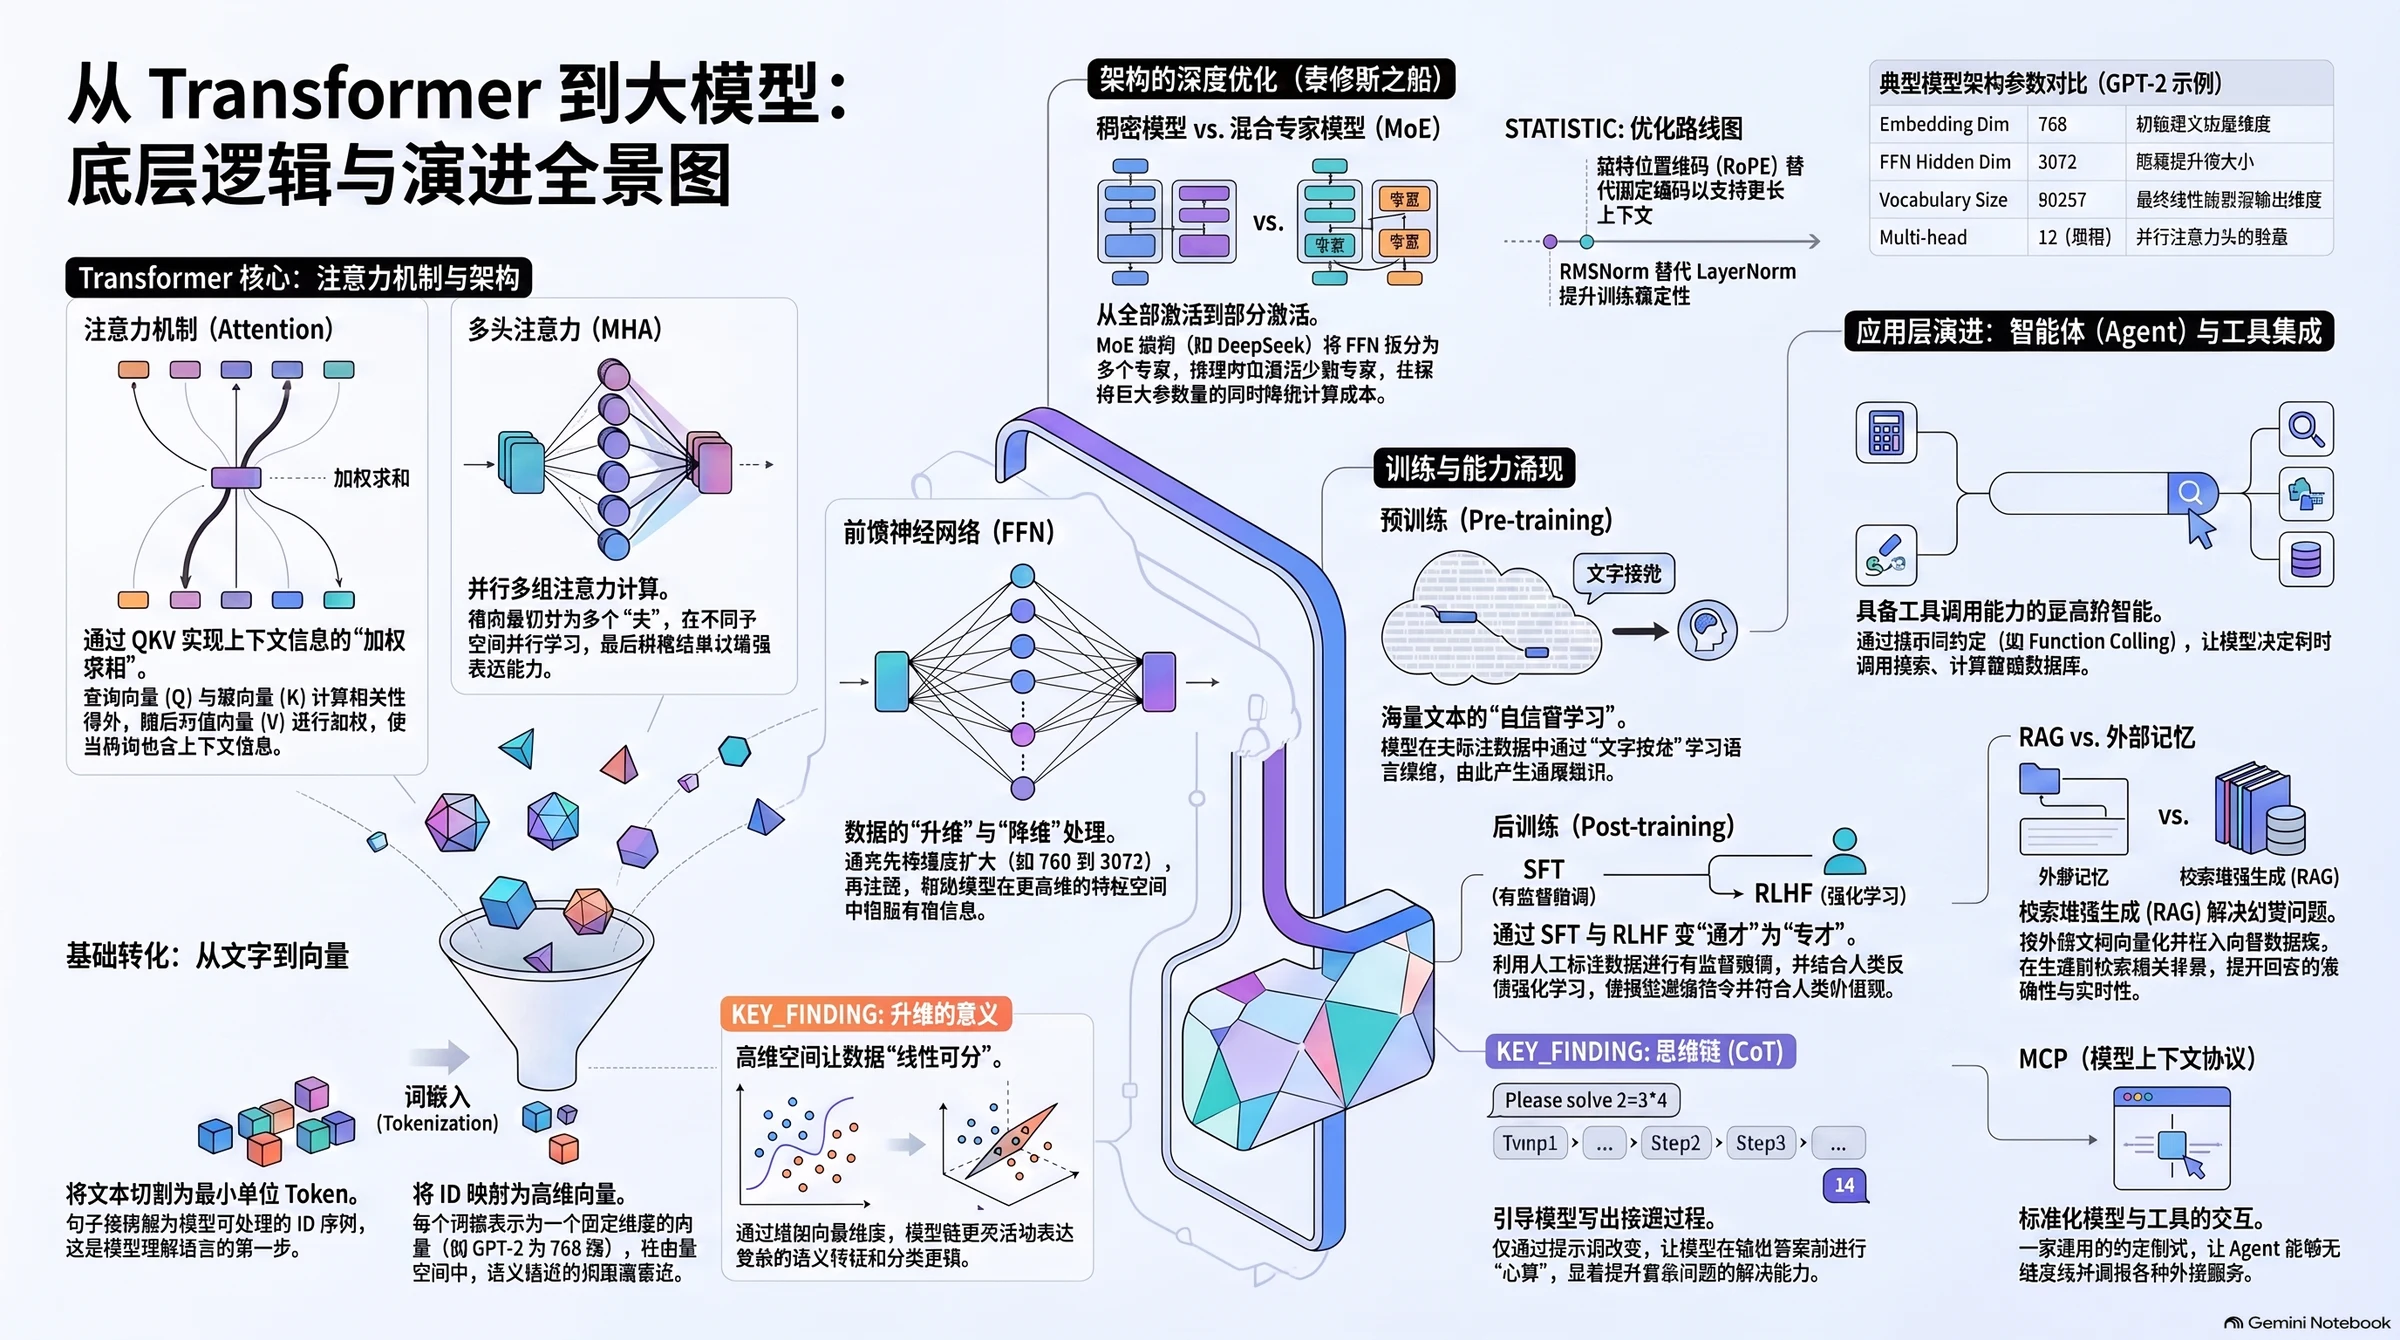
▲ 图2|大模型底层逻辑演进全景(从 Transformer 到大模型:架构深度优化的”忒修斯之船”)
目录
- 第一部分 · Transformer 第一性原理(原理链)
- 第二部分 · 架构演进史(时间线)
- 第三部分 · 训练三阶段与能力涌现
- 第四部分 · 外围生态:Agent / RAG / MCP / Workflow
- 第五部分 · 架构”魔改”图鉴与 Scaling Law
- 关键数值 / 术语记忆表
- 相关笔记
第一部分 · Transformer 第一性原理
核心主张:摒弃术语滤镜,从第一性原理重构 AI 底层逻辑。 无论模型多大、名字多花哨,水面之下的内核永远是一条固定的流水线。
1.1 一切皆函数:剥去智能的伪装
- AI 的核心只是「输入与输出」:
y = f(x)。神经网络是通用函数形式:y = f(X·W + B)(权重 W、偏置 B)。 - 大模型的终极目标极其简单:给定前面的词(X),预测下一个词(Y),即 next-token prediction(猜词游戏)。
- 所谓的”智能”只是用极其庞大的神经网络对明确定义的输入输出做暴力数学求解。
1.2 语言的”数字升维”:词 → 高维向量
三阶段流水线:Tokenization(分词)→ Embedding Matrix(词嵌入)→ 语义即距离。
- 分词(Tokenizer):把文本切成模型可读的最小单元 Token(如”苹果”)。
- 词嵌入(Embedding):不需人工定义特征,靠盲目训练学到一个随机初始化的矩阵,把 Token 映射成高维向量(GPT-2 为 768 维),如”苹果”→
[0.2, -1.5, 0.8, …]。 - 语义即距离:在 768 维空间中,方向一致、余弦相似度大的向量语义高度相关。语义近的词(苹果↔香蕉)离得近,无关词(↔小米/汽车)离得远。
这解决了 N-gram 的”语义文盲”:统计模型眼中每个词都是孤立符号,而向量空间自动让相似词聚集,从而具备泛化能力。
1.3 上下文缺失 → 加权求和破局(注意力的本质)
- 孤立网络的致命伤:只输入当前词,永远无法理解语境(“今天天气”→“真”?)。
- 直白解法:把前文词向量以不同权重加权求和打包进当前词。如
今天(权重 0.4) +天气(权重 0.6) → 汇入当前表达。 - 一句话定性:这就是注意力机制(Attention)的物理本质。
1.4 解剖多头注意力(QKV):查找匹配的锁孔
QKV 三元组的经典比喻:
- Q(Query):当前词”拿着的手电筒”,主动去找相关信息。
- K(Key):前文词”身上挂着的反光板”,等待被照亮比对。
- V(Value):实际被提取并叠加的语义内容。
计算逻辑:每个 Head 从 Token 分裂出 Q/K/V → Q 与所有 K 计算相关性系数(注意力权重/打分)→ 用分数对 V 加权求和 → 汇入注意力结果。
为什么叫”多头”:让同一个词分裂出多组 QKV 向量(Head 1…Head N),各自独立算注意力再拼接(concatenation),从而在不同子空间捕捉多元上下文(语法邻近 / 语义相似 / 指代消解…)。
更深的数学原因见 Transformer注意力机制与推理优化全栈:QKV 分裂打破自身点积的对称性、引入可学习的非对称投影矩阵,模型才拥有”主动查询 Q / 被动索引 K / 内容提取 V”三种独立能力。
1.5 Transformer Block:可以无限堆叠的积木
数据流:Input Vector → Positional Encoding → Multi-Head Attention(MHA) → Add&Norm → FFN → Add&Norm → Output Vector(Add&Norm 带残差连接,可无限堆叠)。
| 组件 | 作用 |
|---|---|
| MHA(多头注意力) | 提取上下文 |
| FFN(前馈网络) | 升维再降维:GPT-2 的 768 → 3072 → 768,高维空间深度萃取特征;因输入输出维度一致,可无限堆叠 |
| Add & Norm(残差+归一化) | 训练的护航者:残差防信号衰减、归一化把均值压向 0、方差压向 1 |
| Positional Encoding(位置编码) | 弥补先天缺陷:加权求和无视顺序,必须强行注入词的位置信息 |
1.6 终极跃迁:预测”下一个词”的概率坍缩
流水线:768 维特征向量 → Linear(线性投影)→ 词表节点(GPT-2 为 50,257 维)→ Softmax → 概率柱状图 → 取 Next Word。
- Linear:把特征映射到整个词表大小(维度大爆炸)。
- Softmax:把 Logits 分数压缩成总和为 1 的概率分布。
- 概率最高的词就是模型输出。
1.7 一份完整的”总装图”
Tokenization → Embedding Matrix → Positional Encoding → Multi-Head Attention → Add/Norm → FFN → Linear Expansion → Softmax → Final Word(Transformer Block 可堆叠 N 次)。
五步第一性原理:① Tokenize & Embed(文本→数字)② Positional Encoding(注入时序)③ Attention(提取上下文)④ FFN(特征升降维萃取)⑤ Linear & Softmax(概率坍缩为词)。万变不离其宗。
第二部分 · 架构演进史(时间线)
一条”能力演化史诗”式时间线:每一次新旧更替都在讲”解决上一代缺陷、又暴露新问题”。
统计学派 N-gram ──(缺陷:组合爆炸+语义文盲)──▶ 词向量 Embedding(余弦相似度度量语义)
   └─▶ 前馈网络 FFNN(泛化)──(缺陷:固定视窗→长距离失忆)──▶
循环网络 RNN(Hidden State 滚动记忆)──(缺陷:长期依赖遗忘)──▶
LSTM(Cell State高速路 + 遗忘/输入/输出三门 + BP)──(缺陷:串行龟速、缺关联聚焦)──▶
(悬念)Attention 注意力机制 → Transformer
2.1 1.0 时代:N-gram(简单粗暴的统计学派)
- 逻辑:只参考前 1 / N 个词,死记硬背”组合出现频次”。如”养了一只___“:猫 10,000 次 / 狗 8,000 次 / 鹦鹉 2,000 次 / 汽车 0 次 → 按频次排序猜下一个词。
- 致命瓶颈:
- 组合爆炸:词表约 10 万词,两两组合高达 100 亿种,现实句子穷举不完。
- 语义文盲:没背过”虎皮鹦鹉”就不知道它和”鹦鹉”的血缘关系 → 预测直接宕机。
2.2 降维打击:词向量 Word Embedding
- 思路:计算机不懂文字,但能理解坐标。把词映射为高维空间中的点;距离越近语义越相似。解决”语义文盲”。
- 度量:余弦相似度(Cosine Similarity)—— “数学不仅能计算星辰轨迹,也能精确描述人类语言的抽象关系。“
2.3 2.0 时代:前馈神经网络 FFNN(举一反三)
- 结构:Token → 隐藏层(非线性变换)→ 输出。
- 关键能力:泛化(Generalize)——发现”鹦鹉”与”虎皮鹦鹉”向量接近,从而把关于鹦鹉的语法规律迁移到从未见过的”虎皮鹦鹉”上。
- 新痛点:固定视窗 → 严重”失忆症”。一次只能看固定数量的词,句子开头的关键线索”像从未存在过” → 长距离依赖无法建模。
2.4 3.0 时代:循环神经网络 RNN(滚动的记忆)
- 机制:打破视窗限制,通过隐藏状态(Hidden State)逐词向后传递信息;每读入一个新词就刷新一次记忆,形成上下文的压缩表示。
- 宿命:记忆褪色。隐状态维度固定,新信息涌入必覆盖旧信息,几十步后开头的关键线索被冲刷殆尽 → 长期依赖遗忘。
2.5 4.0 时代:LSTM(为记忆开辟”VIP 高速公路”)
- 长短时记忆天才之处在于增加一根直通到底的管道:
- 细胞状态(Cell State)=VIP 高速路:重要信息可无损一穿到底。
- 隐藏状态(Hidden State)=短期记忆:抓取当下最近关联。
- 三道智能阀门精确控制信息流:
| 阀门 | 作用 | 操作 |
|---|---|---|
| 遗忘门(Forget Gate) | 决断旧垃圾 | 动态切断无用历史干扰 |
| 输入门(Input Gate) | 写入新价值 | 把有用新线索泵进主干道 |
| 输出门(Output Gate) | 精准提取 | 预测瞬间从主干道提取记忆 |
- 自我进化:预测 →(答错)产生误差 → 反向传播 → 参数微调(调阀门开度)→ 再预测。没有任何程序员在写”记住鹦鹉”的代码,是”千万次答错→挨打→调整”中自己悟出该记什么。
2.6 最后的瓶颈:打破”顺序的枷锁”→ Transformer
- 串行瓶颈:LSTM 靠逐词串行,面对海量数据龟速串行成为致命伤。
- 终极追问:能否打破顺序?能否让句子中每个词瞬间锁定与自己最关联的信息(无视距离、全部并行)?
- 答案:这就是注意力机制(Attention) 与 Transformer 登场时刻。核心革新:Token 之间的依赖体现为”数据排列(矩阵)“而非”时间先后(循环)“,天然并行。
演进矩阵对比:N-gram(纯统计计数/极短上下文/语义文盲)→ FFNN(语义词向量/固定视窗/失忆)→ RNN(隐状态记忆/可变但有限/长期遗忘)→ LSTM(细胞状态+门控/长/串行龟速)→ Transformer(注意力/全并行)。
更多架构演进细节见:分析大模型架构进展(从GPT1-DeepseekR1)、大模型架构进化树(交互工具)、大语言模型简史2025。
第三部分 · 训练三阶段与能力涌现
从海量噪音到逻辑推理,三个阶段逐级进化:
- [Pre-training 预训练] · Self-Supervised(文字接龙):无需人工标注,用海量粗糙文本做自监督学习;练就”无所不知但缺乏规范”的通才,并涌现出少样本学习(Few-shot learning)能力。
- [SFT 监督微调]:用人工精标的一问一答数据二次训练,让模型停止无意义接龙,练就专攻对话的专才。
- [RLHF / CoT] · 思维链:不改变架构参数,仅靠提示词逼迫模型”把心算过程大声说出来”,直接突破逻辑推理上限。
关键认知:SFT 通才→专才,RLHF/CoT 鞭策推理。训练细节见 RLHF训练性能波动深度解析、RLHF的强大之处-GPT3到ChatGPT。
第四部分 · 外围生态:Agent / RAG / MCP / Workflow
残酷真相:大模型自身底层逻辑并未突变,变的是我们在外围包裹的”伪装逻辑”。
4.1 Agent 只是程序代理
环形结构(由内到外):智障模型(Raw LLM) 在最内层 → 外层 Prompt(给单次接龙方向)→ Context & Memory(伪装多轮对话:模型没有真记忆,只是每次把历史记录硬塞回上下文)→ Agent(用传统程序代理模型,替它拦截需求、分发任务,让它”看起来像”。有自主能力)。
4.2 RAG(检索增强生成):填补认知盲区
放弃让大模型死记硬背,外挂向量数据库:外部文档切片入库 → 语义相似度检索相关片段 → 喂给模型作回答依据。解决”外记忆 vs 幻觉”。
4.3 Function Calling / MCP:打破”只说不做”
- Function Calling:强制模型输出结构化 JSON,让外部程序能精准截获并执行动作。
- MCP(模型上下文协议):标准化”模型如何描述、发现、调用工具”。详见 Agent 结构化输出与工具调用(Function Calling / Tool Use / MCP / 校验)。
4.4 Workflow:驯服不可控
让 Agent 完全自由发挥既不稳定又耗 Token → 收束为固定管线:开发者视角用 LangChain/Skills 写死脚本,用户视角用低代码拖拽(如 Read PDF → Translate → Output Word)固化确定性流程。
第五部分 · 架构”魔改”图鉴与 Scaling Law
5.1 大厂架构”魔改”图鉴(螺蛳壳里做道场)
解开”百花齐放”的真相:目前的创新几乎全部集中在极少的可改动点上,底层 Transformer 基座未被颠覆。
| 架构模块 | 技术选项 |
|---|---|
| 位置编码 | RoPE(旋式位置嵌入)、NoPE |
| 归一化 | Pre/Post Norm、QK Norm、RMSNorm |
| 注意力 | MQA/GQA、MLA(DeepSeek)、Sparse/Linear(Mamba) |
| 前馈网络 | Dense(稠密)→ MoE(混合专家) |
- MoE 稀疏化:把巨大 FFN 拆成多个”专家(Expert)“,由 router(路由器) 分配,每次推理只激活部分参数(例:397B 总参、每次只激活 11B),大参数却省算力。
- MoE vs 稠密:稠密模型每个 Token 过全部参数;MoE 只激活 Top-2 专家 → 模型可以更大但单 Token 计算量不暴涨(Grok、Gemini 越做越大的关键)。
5.2 莫拉维克悖论 与 Scaling Law 启示录
- The Bitter Lesson(苦涩的教训):人类自以为是的”精巧架构设计”,长期看反而阻碍模型在大规模算力下的自我学习速度。
- 核心要素集:
Inputs/Outputs · Neural Nets · Compute · Scale,周边技术(RoPE、MQA、Agent Workflows、Prompt Engineering)都只是依托核心 Scale 属性的应用分支。 - 清醒结论:当开源/闭源差距缩短、架构红利见顶时,进化的本质回归于 算力规模(Scale)的暴力美学与底层数据质量。Scaling Law 与数据质量才是长期进化的真正驱动力。
关键数值 / 术语记忆表
| 项目 | 数值/要点 |
|---|---|
| GPT-2 特征维度 | 768 |
| GPT-2 FFN 升维 | 768 → 3072 → 768 |
| GPT-2 词表 | 50,257 |
| MoE 稀疏示例 | 397B 总参,只激活 11B |
| N-gram 组合爆炸 | 10 万词两两组合 ≈ 100 亿种 |
| 语义度量 | 余弦相似度(Cosine Similarity) |
| 注意力本质 | 加权求和 / Q(手电筒)-K(反光板)-V(内容) 锁孔 |
| LSTM 三阀门 | 遗忘 / 输入 / 输出门 |
| 训练三阶段 | Pre-training(通才)→ SFT(专才)→ RLHF/CoT(推理) |
| 外层生态 | Agent(程序代理) · Memory(塞历史) · RAG(外挂知识) · FC/MCP(执行) · Workflow(收束) |
| 架构可改点 | RoPE · RMSNorm · MQA/GQA/MLA · MoE |
| 长期驱动力 | Scaling Law + 数据质量(Bitter Lesson) |
相关笔记
- transformer架构和自注意力机制 — Transformer 架构详解(原理向)
- Transformer注意力机制与推理优化全栈 — 注意力数学 → 推理部署优化全栈
- 分析大模型架构进展(从GPT1-DeepseekR1) — GPT-1 到 DeepSeek-R1 架构演进
- 大模型架构进化树(交互工具) — 2017–2025 架构进化树(可交互)
- 大语言模型简史2025 — 从 Transformer 到 DeepSeek-R1
- 从seq2seq到attention — 注意力机制前身
- 大模型技术发展与演进 — Transformer/Decoder 深度问答
- Agent 结构化输出与工具调用(Function Calling / Tool Use / MCP / 校验) — 外围 Agent 工具调用生态
- AI 大模型 MOC — 领域内容地图