循环工程的艺术(The Art of Loop Engineering)
说明
LangChain 官方博客文章(原文直译整理),作者 Sydney Lenker,2026-06-16。把 Agent 的核心算法抽象成四层可堆叠循环(Agent → 验证 → 事件驱动 → 爬坡),并给出每一层的 LangChain 原生实现。
配图原文:相关「视频解读」见 LangChain Loop Engineering 四层架构(带时间轴展开 & 关键术语修正)。本页保留原文的 LangChain 原语与官方口径。
核心命题
智能体之所以有用,是因为它们能通过在现实世界中采取行动来帮助我们实现工作自动化。但要让它可靠地完成有价值的工作,仅有好模型不够,还需要一个精心设计、适配特定任务的外围框架(Harness)。
- 核心智能体算法很简单:给 LLM 上下文,让它循环调用工具、直到完成(最基本的循环)。
- 但这不是唯一驱动 Agent 的循环。Swyx 在「Loop Tricks: The Art of Loop Stacking」阐释了如何通过堆叠和扩展循环构建更高效的 Agent。
- 下文用 LangChain 原语标注每一层的落点,并全程以「文档写作 Agent」为例。
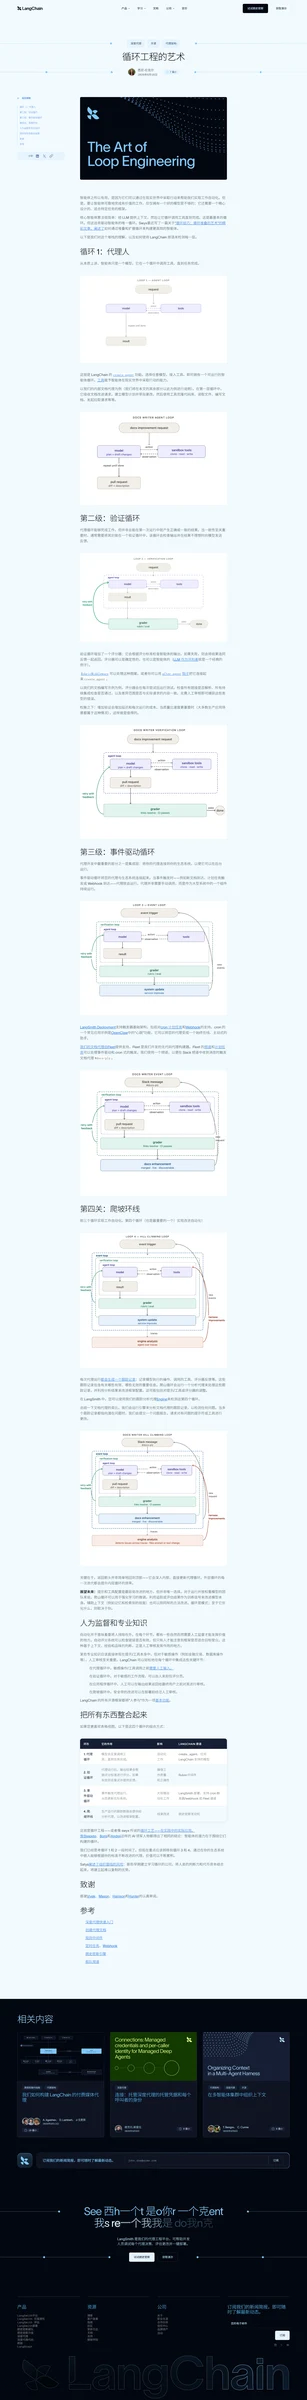
第一层:Agent Loop(代理循环)—— 自动化工作
本质上,Agent 就是一个模型在一个循环里调用工具,直到任务完成。
LOOP 1 — AGENT LOOP
request → model → action(tools) → observation → repeat until done → result
- 这是
create_agent:选任意模型、接入工具,即可运行。 - 工具赋予 Agent「在现实世界中行动」的能力。
- 例(文档写作 Agent):接收改进请求 → 模型建立计划并起草修改 → 用工具克隆仓库/读文件/写文档/发起 PR。
LangChain 原语:create_agent(可配任何 LangChain 支持的模型)
第二层:Verification Loop(验证循环)—— 确保正确
代理循环能干活,但一次运行不一定正确一致。当一致性至关重要时,把它包进一个验证循环:检查输出,不理想就带反馈送回模型。
LOOP 2 — VERIFICATION LOOP
agent loop → result → grader(rubric/eval) → pass→done | fail→retry with feedback
- 加一个 Grader(评分器):按评分标准检查输出,失败则连同反馈返回重试。Grader 可以是确定性脚本,也可以是 Agent(经典例:LLM-as-judge)。
- LangChain 原语:
RubricMiddleware,或用after_agent钩子接到create_agent。 - 例:Grader 每次尝试后跑测试,检查①所有链接是否解析②CI 是否通过③Diff 范围与实际请求是否一致——无需人工即可捕获此类错误。
- 权衡:验证增加延迟与每次运行的成本;当质量优先于速度(大多数生产场景)时值得。
第三层:Event-Driven Loop(事件驱动循环)—— 规模化入系统
Agent 开发中最重要的是集成层:把 Agent 连进你的生态,让它能在后台持续运行。事件触发(新文档到达 / 定时任务 / Webhook)时才运行——Agent 不是被手动调用,而是作为大型系统的常驻组件。
LOOP 3 — EVENT LOOP
event trigger(cron / webhook / channel) → verification loop(agent loop…) → system update → service improves → new events
- LangChain 原语:
LangSmith Deployment(支持 cron & Webhook 触发器);Fleet(无代码 Agent 构建器,常用其「频道 channel」与「计划任务」)。 - cron 常见案例:OpenClaw 的「心跳」功能 —— 把 Agent 变成常驻、主动式的助手。
- 例:文档 Agent 用 Fleet 频道
#docs-plz监听 Slack,频道里来消息即触发。
第四层:Hill-Climbing Loop(爬坡循环 / 改进循环)—— 让系统自己变好
前三个循环让工作自动化;第四个(也最重要的)让改进自动化。
LOOP 4 — HILL CLIMBING LOOP
event loop(…verification loop(…agent loop…)) → result
   ↘ traces ⇢ engine analysis(agent over traces) ⇢ harness improvements → 回到内层
- 每次运行生成 Trace:记录的模型动作、调用工具、Grader 反馈、(失败/通过)。Trace 含「哪些有效、哪些无效」的关键信息。
- 爬坡循环:跑一个分析 Agent 处理这些 Trace,用分析结果改进框架配置 —— 调整提示/工具/评分器。
- 关键在于:返回箭头不是简单回顶部,而是深入内部直接更新 Agent 循环——外层循环的每一次迭代都提升内层循环的效率。
- LangChain 原语:
LangSmith Engine(跟踪分析 Agent)。 - 例:引擎分析文档 Agent 的 Trace,多处 Trace 都指向某问题时,提交一个问题报告,请求改有问题的提示或工具。
展望:爬坡循环不只是改 Prompt
- 提示 & 工具配置是最易改的,但不是唯一。
- 运行开放权重模型的团队,可用爬坡循环做强化学习微调,把 Trace/评估结果当训练信号改进模型本身。
- 辅助上下文(记忆、检索到的 Skills)也可用同样方法优化。
- 循环是模式;它优化什么,取决于你。
人为监督:自动化不等于排除人
在每一层,都有自然需要人工监督才能发挥价值的环节:
| 循环层 | 需要人把关的环节 |
|---|---|
| Agent Loop | 敏感操作/工具调用(金融交易、数据库操作)前需人工输入 |
| Verification Loop | 敏感工作流可由人担任 Grader |
| Event / 应用循环 | 输出结果返回最终用户前人工审核 |
| Hill-Climbing Loop | 框架/安全带改进在部署前人工审核 |
自动评分能查链接是否有效,但只有人能判断框架是否适合目标受众——基于上下文、经验与品味的主判断,正是人工审核的价值。LangChain 所有开源框架把「人参与」作为基本能力。
把所有东西整合起来(四层总览表)
| 环形 | 它的作用 | 影响 | LangChain 原语 |
|---|---|---|---|
| 1. Agent Loop | 模型反复调用工具直到任务完成 | 自动化工作 | create_agent,任何 LangChain 支持的模型 |
| 2. Verification Loop | 代理运行后按评分标准评分,失败则带反馈重试 | 确保工作正确 | RubricMiddleware |
| 3. Event-Driven Loop | 事件触发代理运行,更新实际系统 | 大规模自动化工作 | LangSmith Deployment(cron/webhook)或 Fleet 频道 |
| 4. Hill-Climbing Loop | 生产 Trace 喂给分析 Agent,改进框架配置 | 框架(Harness)自我改进 | LangSmith Engine |
结尾观点
- 这就是循环工程(Loop Engineering)——或 Swyx 所说的「循环工艺(Loop Craft)」。Steipete、Boris、Andrej 等 AI 领军人物得出同一结论:智能体的潜力在于围绕它们构建的循环。
- 很多人已思考 Loop 1 和 2;现在重点应转向 Loop 3 和 4——把能在你的生态里按你的标准不断改进的 Agent 嵌入系统,价值会持续累积。
- Satya 观点:早期建立学习循环的公司,把人类判断力与 token 资本结合,将建立起难以复制的优势。
相关笔记
- LangChain Loop Engineering 四层架构 — 同主题的视频解读(时间轴展开 + 关键术语修正)
- 12种 Agent Harness 设计模式 — Harness 与上下文/工具/验证的设计谱系
- Claude Code 架构深度拆解 — 生产级 Agent 的 Trace/恢复/改进机制实例
- AI 大模型 MOC