Agent 基础丨大厂面试(九大能力板块)
摘要
互联网岗位 Agent 基础的系统梳理,覆盖面试常考的 9 大板块:Agent、Workflow、Tool Calling、Memory、Planning、Reflection、Human-in-the-loop、Fallback、Permission / Audit Log。
核心一句话:Agent 的本质不是「更会聊天」,而是「能把任务做完」 —— 会感知、会决策、会调用工具、且可追溯。
来源:抖音图文
📋 板块总览
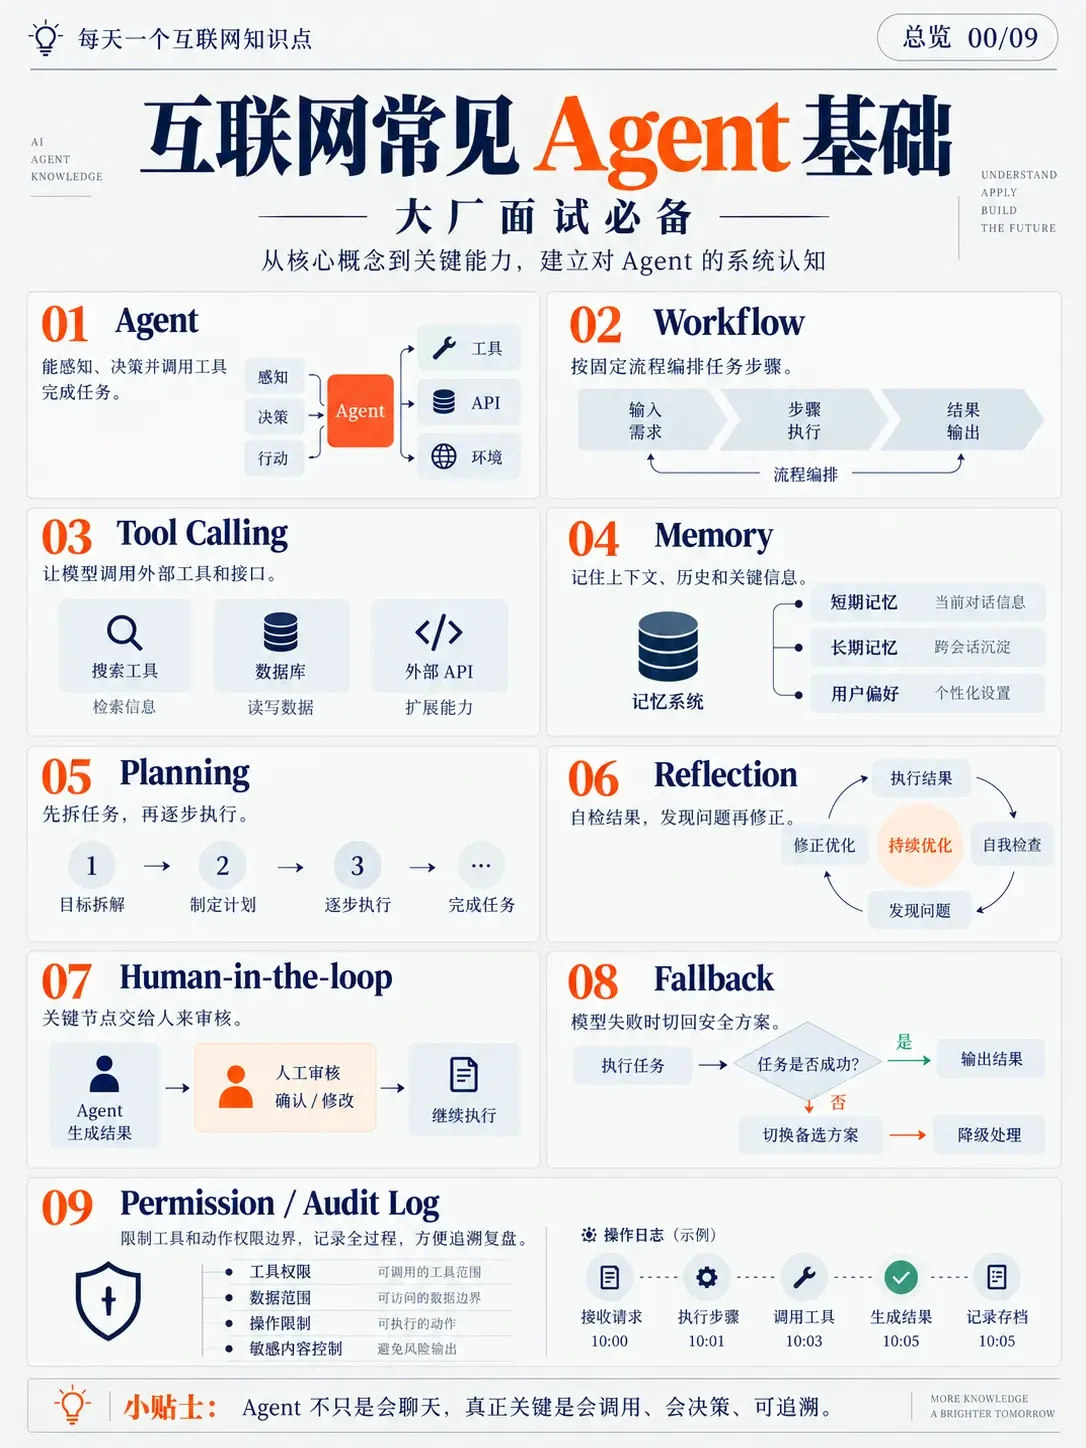
一、Agent(任务执行体)
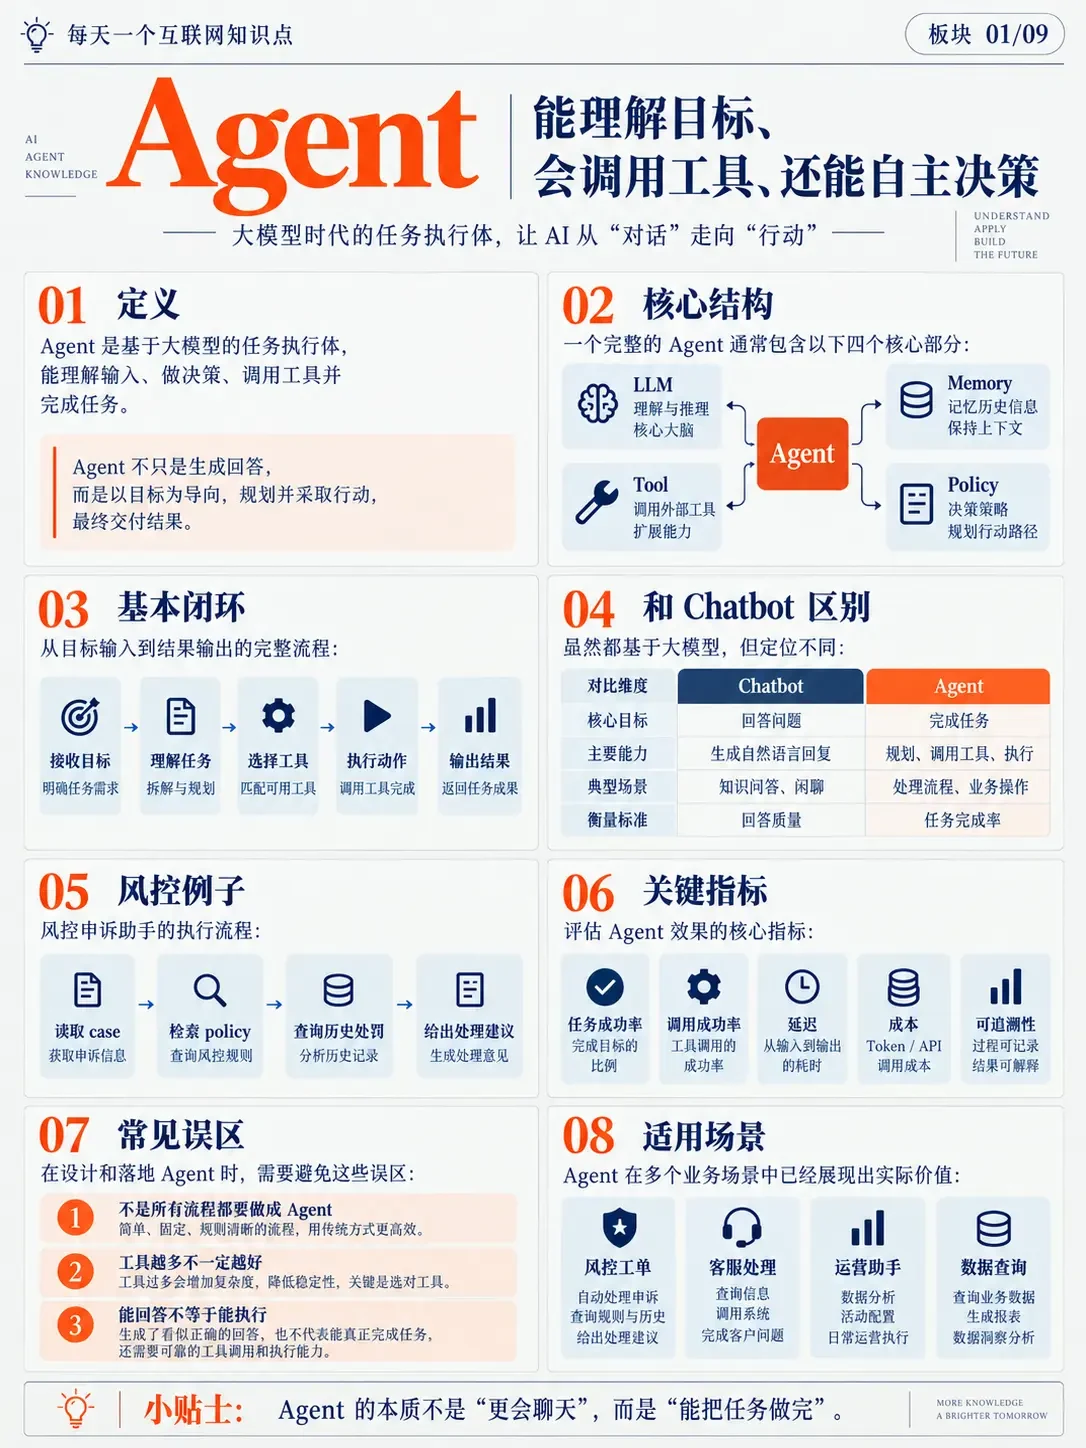
定义:Agent 是基于大模型的任务执行体,能理解输入、做决策、调用工具并自主完成任务 —— 让 AI 从「对话」走向「行动」。
核心结构(4 部分):LLM(理解推理·大脑) + Memory(记忆历史) + Policy(决策策略·规划行动) + 工具调用(扩展能力)。
基本闭环:接收目标 → 理解任务 → 选择工具 → 执行动作 → 输出结果。
与 Chatbot 的区别:
| 维度 | Chatbot | Agent |
|---|---|---|
| 核心目标 | 回答问题 | 完成任务 |
| 主要能力 | 生成自然语言回复 | 规划、调用工具、执行 |
| 典型场景 | 知识问答、闲聊 | 处理流程、业务操作 |
| 衡量标准 | 回答质量 | 任务完成率 |
关键指标:任务成功率、工具调用成功率、延迟(输入到输出耗时)、成本(token/API)、可追溯性(过程可记录、结果可解释)。
常见误区:①不是所有流程都要做成 Agent(简单固定流程用传统方式更高效);②工具越多不一定越好(增加复杂度、降低稳定性,关键是选对);③能回答 ≠ 能执行(需要可靠的工具调用与执行能力)。
风控例:读取 case → 查询风控规则 → 分析历史记录 → 生成处理意见(工具闭环)。
二、Workflow(工作流)
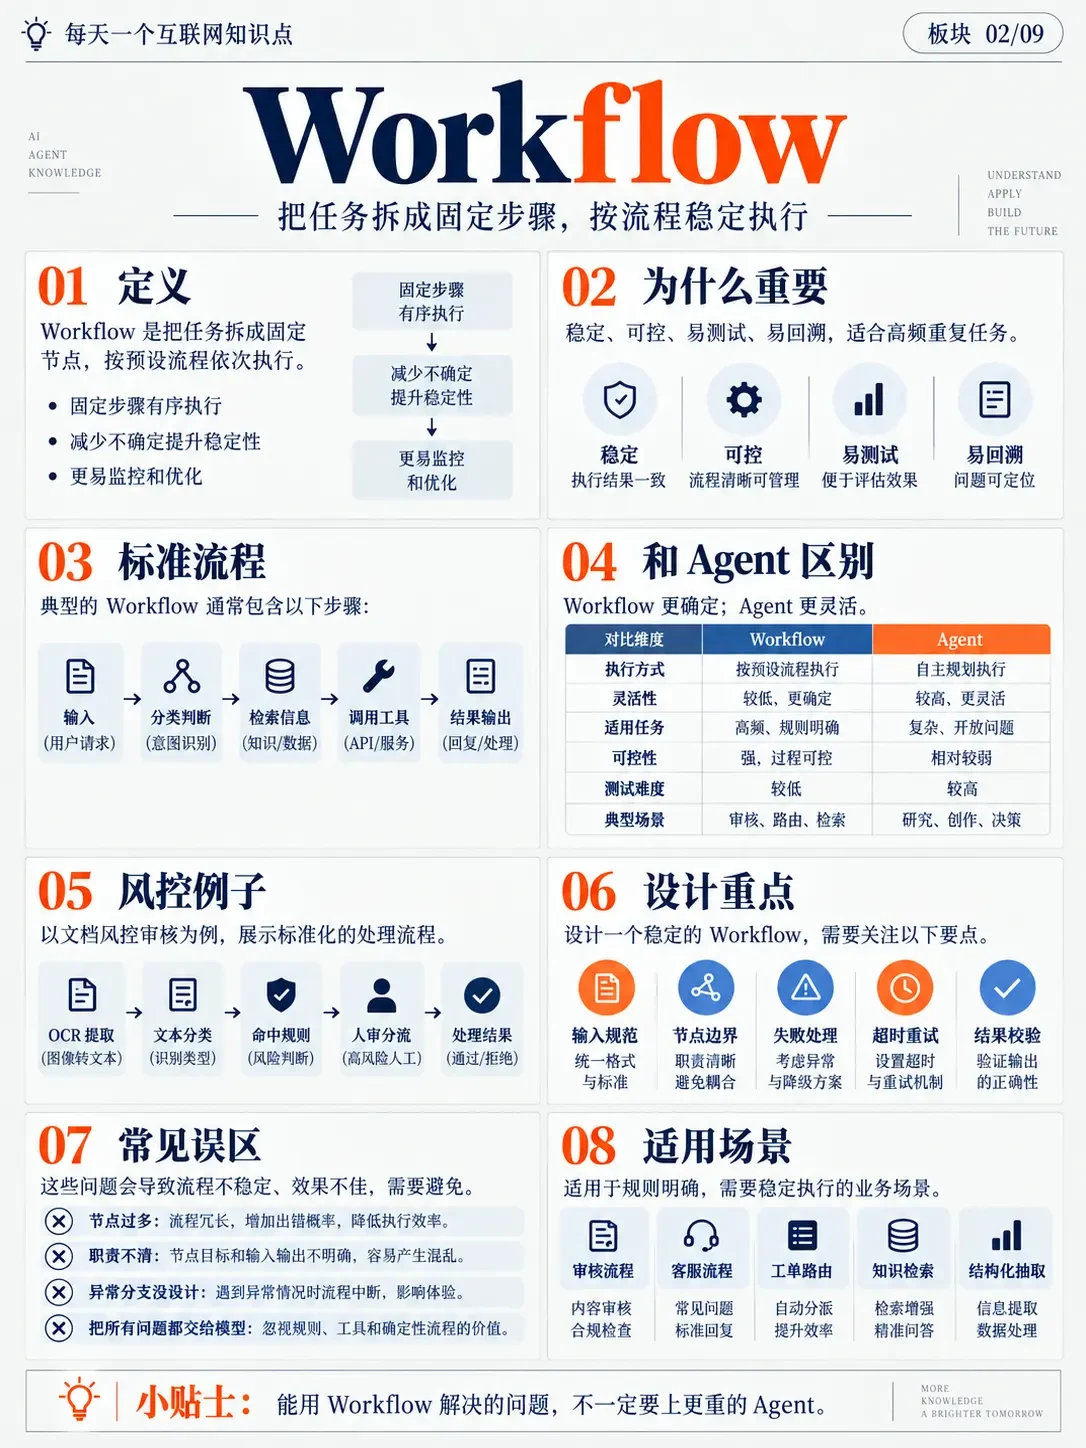
定义:把任务拆成固定节点,按预设流程依次执行。
为什么重要:稳定、可控、易测试、易回溯,降低不确定性,适合高频重复任务。
标准流程:输入(用户请求)→ 分类判断(意图识别)→ 检索信息(知识/数据)→ 调用工具(API/服务)→ 结果输出(回复/处理)。
与 Agent 的区别:
| 维度 | Workflow | Agent |
|---|---|---|
| 执行方式 | 按预设流程执行 | 自主规划执行 |
| 灵活性 | 较低,更确定 | 较高,更灵活 |
| 适用任务 | 高频、规则明确 | 复杂、开放问题 |
| 可控性 | 强,过程可控 | 相对较弱 |
| 测试难度 | 较低 | 较高 |
设计重点:输入规范(统一格式)、节点边界(职责清晰、避免耦合)、失败处理(异常与降级方案)、超时重试、结果校验(验证输出正确性)。
常见误区:节点过多(流程长易出错)、职责不清、异常分支没设计(流程中断)、把所有问题交给模型(忽视规则/工具/确定性流程的价值)。
能用 Workflow 解决的问题,不一定要上更重的 Agent。
三、Tool Calling(工具调用)
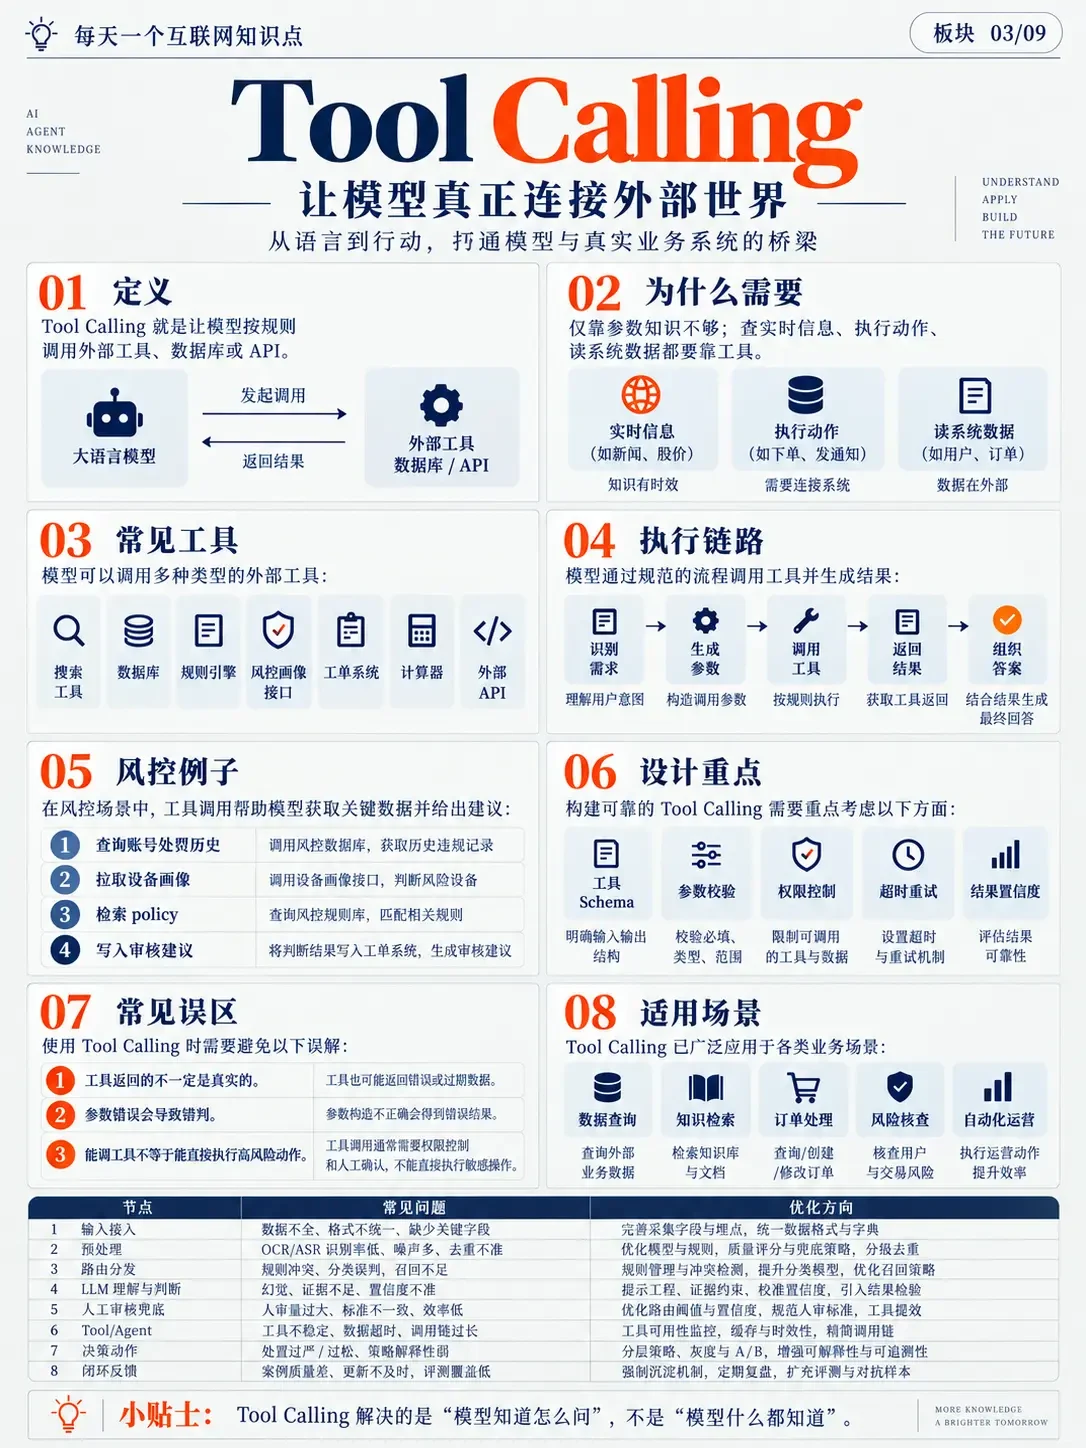
定义:让模型按规则调用外部工具、数据库或 API,打通「语言」与「行动」。
为什么需要:模型参数知识有时效,实时信息、执行动作、读系统数据都靠工具。
常见工具:搜索、数据库、规则引擎、风控画像、工单系统、计算器、外部 API。
执行链路:识别需求(理解用户意图)→ 生成参数(构造调用参数)→ 调用工具(按规则执行)→ 返回结果(获取工具返回)→ 组织答案(结合结果生成最终回答)。
设计重点:工具 Schema(明确输入输出结构)、参数校验(必填/类型/范围)、权限控制(限制可调用的工具与数据)、超时重试、结果置信度评估。
常见误区(面试高频):
- 工具返回的不一定是真的 —— 工具也可能返回错误或过期数据,参数构造不正确会得到错误结果。
- 能调工具 ≠ 能直接执行高风险动作 —— 工具调用通常要权限控制和人工确认,不能直接执行敏感操作。
Tool Calling 解决的是「模型知道怎么问」,不是「模型什么都知道」。
四、Memory(记忆)
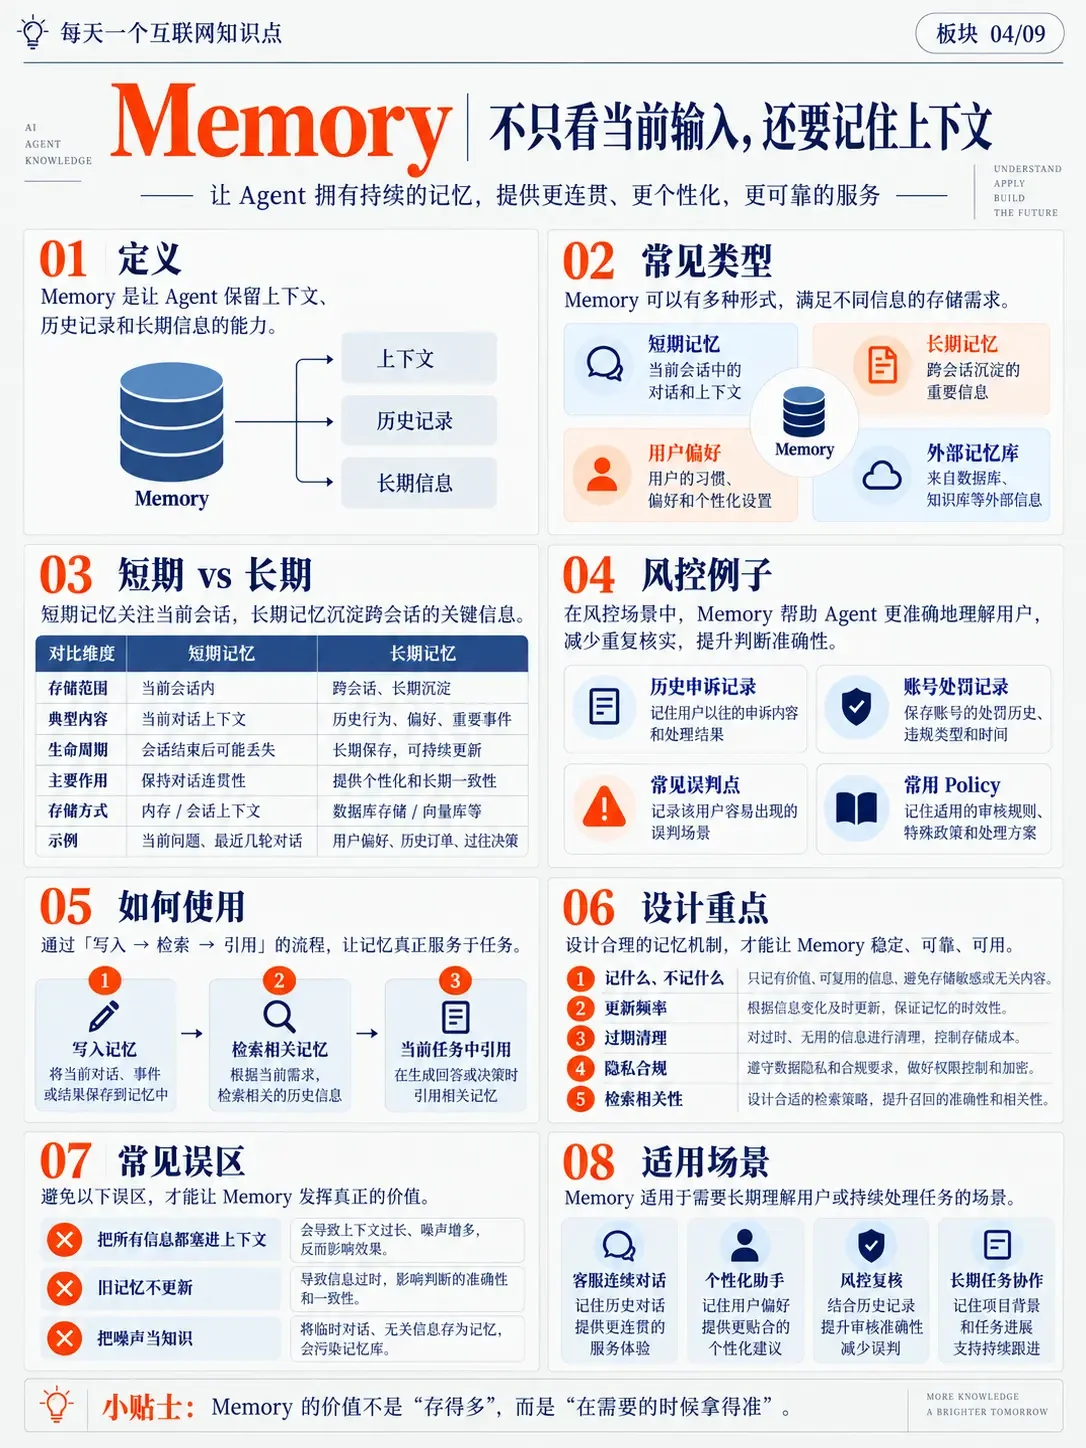
定义:让 Agent 保留上下文、历史记录和长期信息的能力,提供更连贯、更个性化、更可靠的服务。
两种类型:
| 维度 | 短期记忆 | 长期记忆 |
|---|---|---|
| 存储范围 | 当前会话内 | 跨会话、长期沉淀 |
| 典型内容 | 当前对话上下文 | 历史行为、偏好、重要事件 |
| 生命周期 | 会话结束后可能丢失 | 长期保存、可持续更新 |
| 主要作用 | 保持对话连贯性 | 提供个性化与长期一致性 |
| 存储方式 | 内存/会话上下文 | 数据库/向量库等 |
如何使用:写入记忆 → 检索相关记忆 → 当前任务引用(写→检索→引用的闭环)。
设计重点:记什么不记什么(只记有价值可复用的,避免敏感/无关)、更新频率、过期清理(控制存储成本)、隐私合规(权限控制与加密)、检索相关性(提升召回准确性)。
常见误区:把所有信息塞进上下文(噪声增多反而影响效果)、旧记忆不更新(信息过时)、把临时对话/无关信息存为记忆(把噪声当知识)。
Memory 的价值不是「存得多」,而是「在需要的时候拿得准」。
五、Planning(规划)
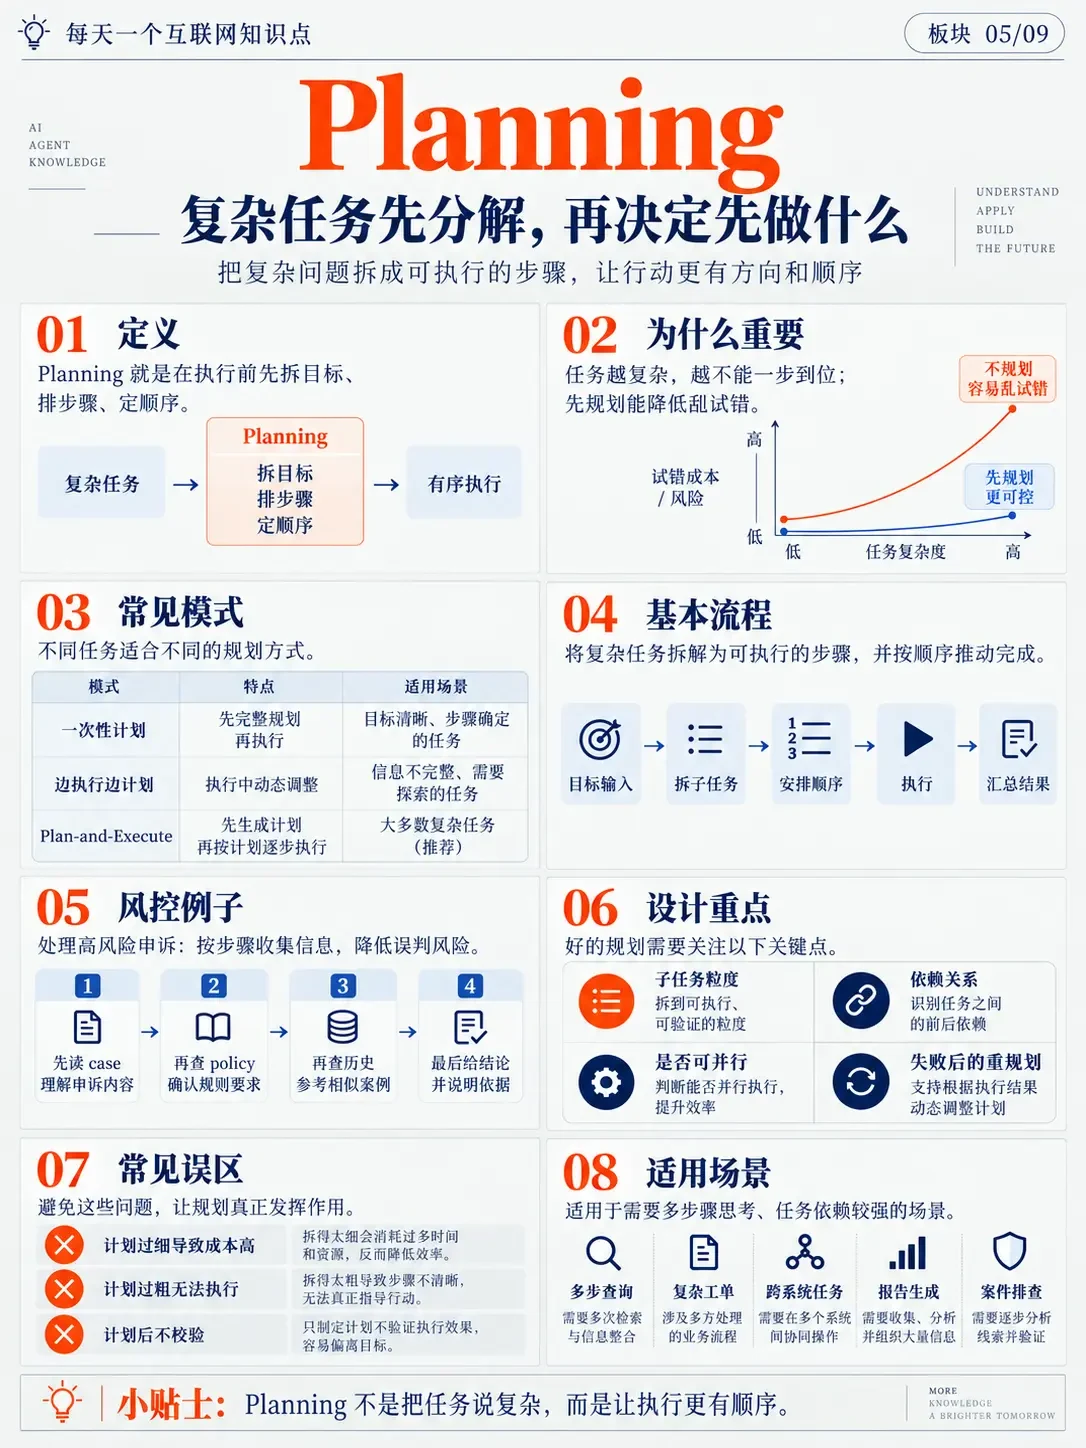
定义:执行前先拆目标、排步骤、定顺序,让行动更有方向和顺序。
为什么重要:任务越复杂越不能一步到位;先规划能降低试错成本与风险。
常见模式:
- 一次性计划:目标清晰、步骤确定的任务 → 先完整规划再执行
- 边执行边计划:信息不完整、需探索的任务 → 执行中动态调整
- Plan-and-Execute(推荐):先生成计划再按计划逐步执行,适合大多数复杂任务
关键词:规划基本流程:目标输入 → 拆子任务 → 安排顺序 → 执行 → 汇总结果。
设计重点:子任务粒度(拆到可执行可验证)、依赖关系(识别前后依赖)、是否可并行(提升效率)、失败后的重规划(动态调整)。
常见误区:计划过细(成本高、效率低)、计划过粗(无法指导行动)、计划后不校验(容易偏离目标)。
六、Reflection(反思)
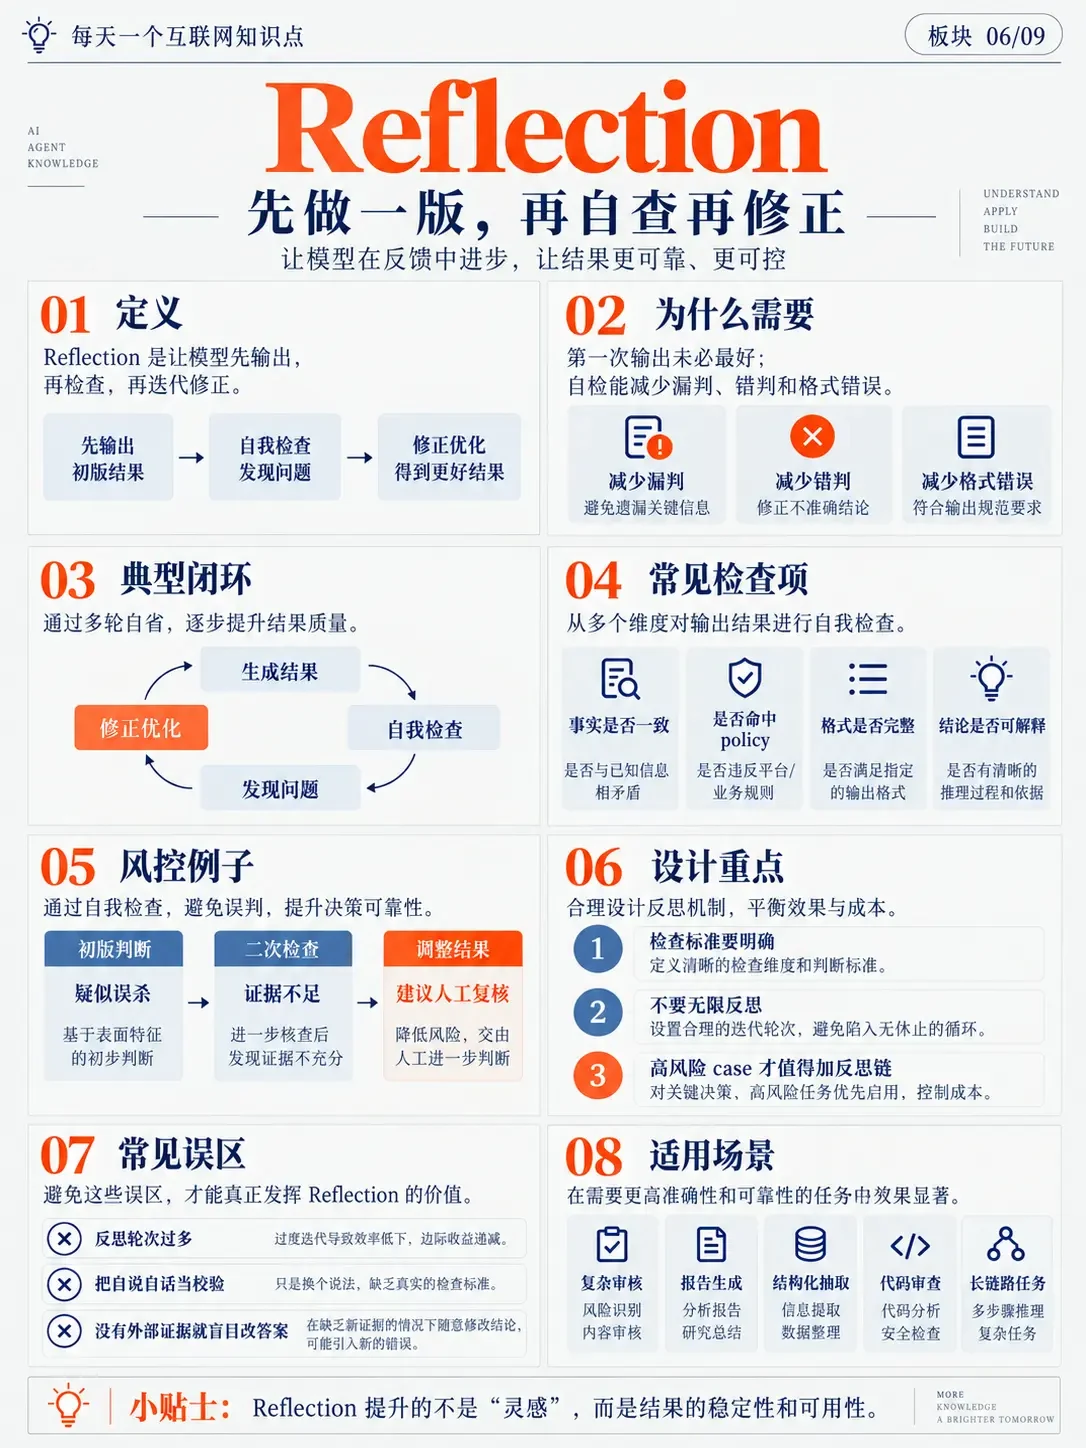
定义:让模型先输出,再自我检查、再迭代修正,让结果更可靠、更可控。
为什么需要:第一次输出未必最好;自检能减少漏判、错判和格式错误。
典型闭环:生成结果 → 自我检查 → 发现问题 → 修正优化 → 更好结果。
常见检查项:事实是否一致(与已知信息相矛盾)、是否命中 policy(违反平台/业务规则)、格式是否完整(满足指定输出格式)、结论是否可解释(有清晰的推理过程和依据)。
设计重点:检查标准要明确(定义清晰维度与判断标准)、不要无限反思(设置合理迭代轮次)、高风险 case 才值得加反思链(控制成本)。
常见误区:反思轮次过多(边际收益递减)、把自说自话当校验(缺乏真实检查标准)、没有外部证据就盲目改答案(可能引入新错误)。
Reflection 提升的不仅是「灵感」,而是结果的稳定性和可用性。
七、Human-in-the-loop(人机回环)
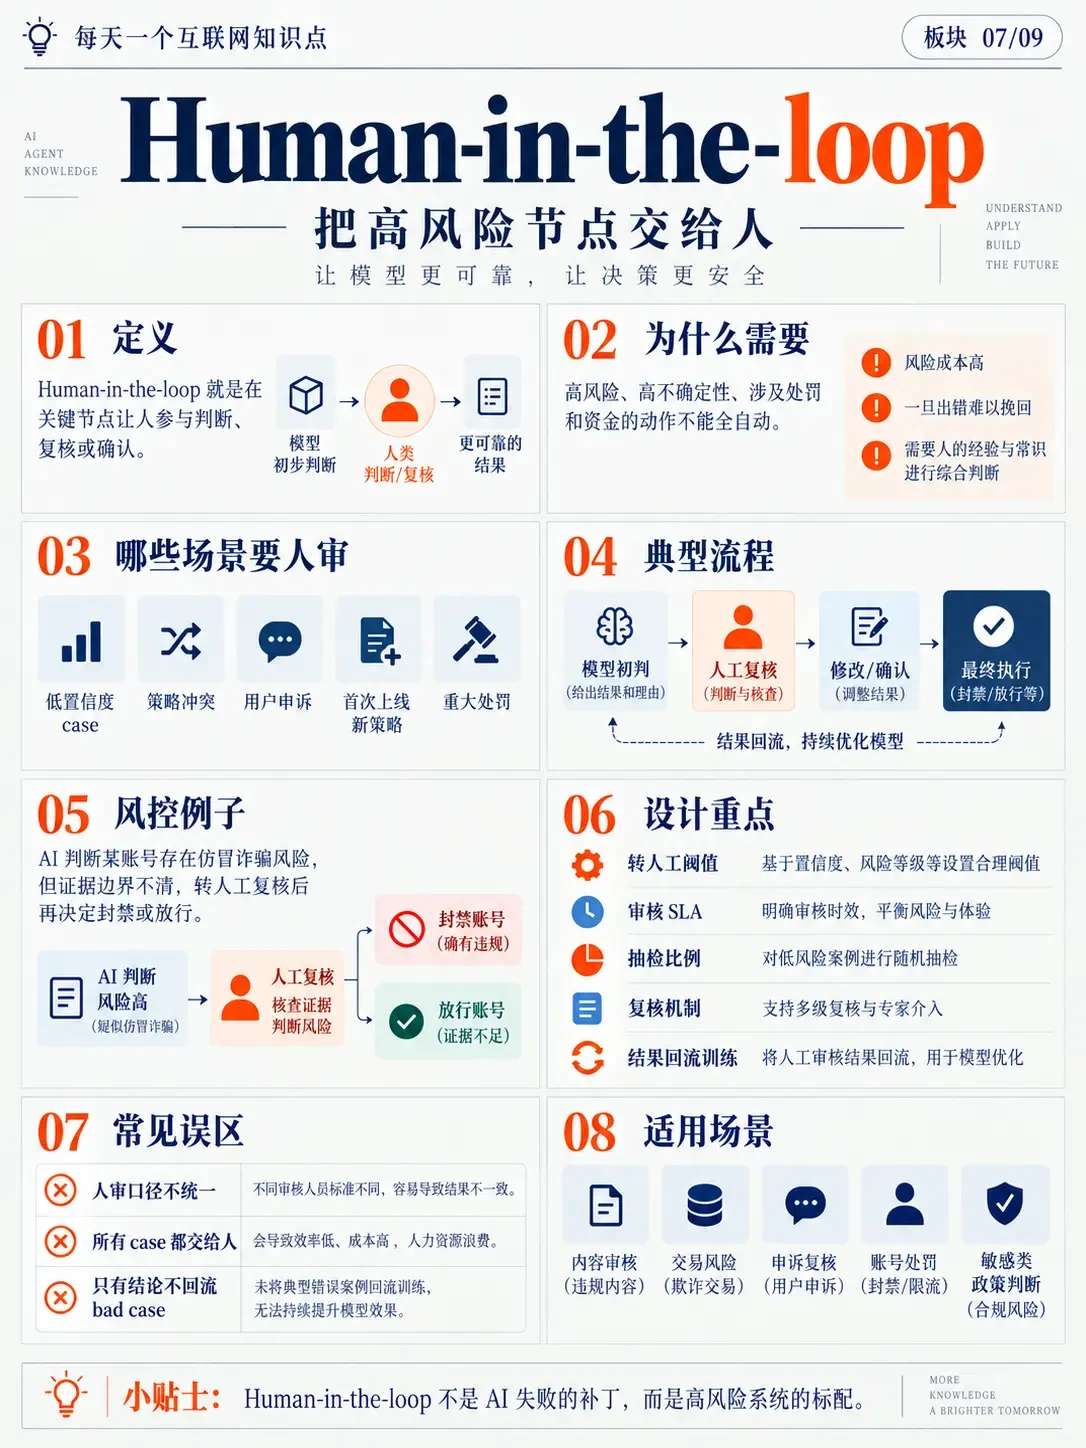
定义:在关键节点让人参与判断、复核或确认,让模型更可靠、让决策更安全。
为什么需要:风险成本高、一旦出错难挽回、需要人的经验与常识进行综合判断。
哪些场景要人审:低置信度 case、策略冲突、用户申诉、首次上线、重大处罚/新策略。
典型流程:模型初判(给出结果和理由)→ 人工复核(判断与核查)→ 修改/确认(调整结果)→ 最终执行(封/放行等)→ 结果回流(持续优化模型)。
设计重点:转人工阈值(基于置信度/风险等级设置)、审核 SLA(明确时效,平衡风险与体验)、抽检比例(低风险随机抽检)、复核机制(支持多级复核与专家介入)、结果回流训练。
常见误区:所有 case 都交给人(效率低成本高)、人审口径不统一(结果不一致)、只结论不回流(bad case 无法持续提升模型)。
Human-in-the-loop 不是 AI 失败的补丁,而是高风险系统的标配。
八、Fallback(降级兜底)
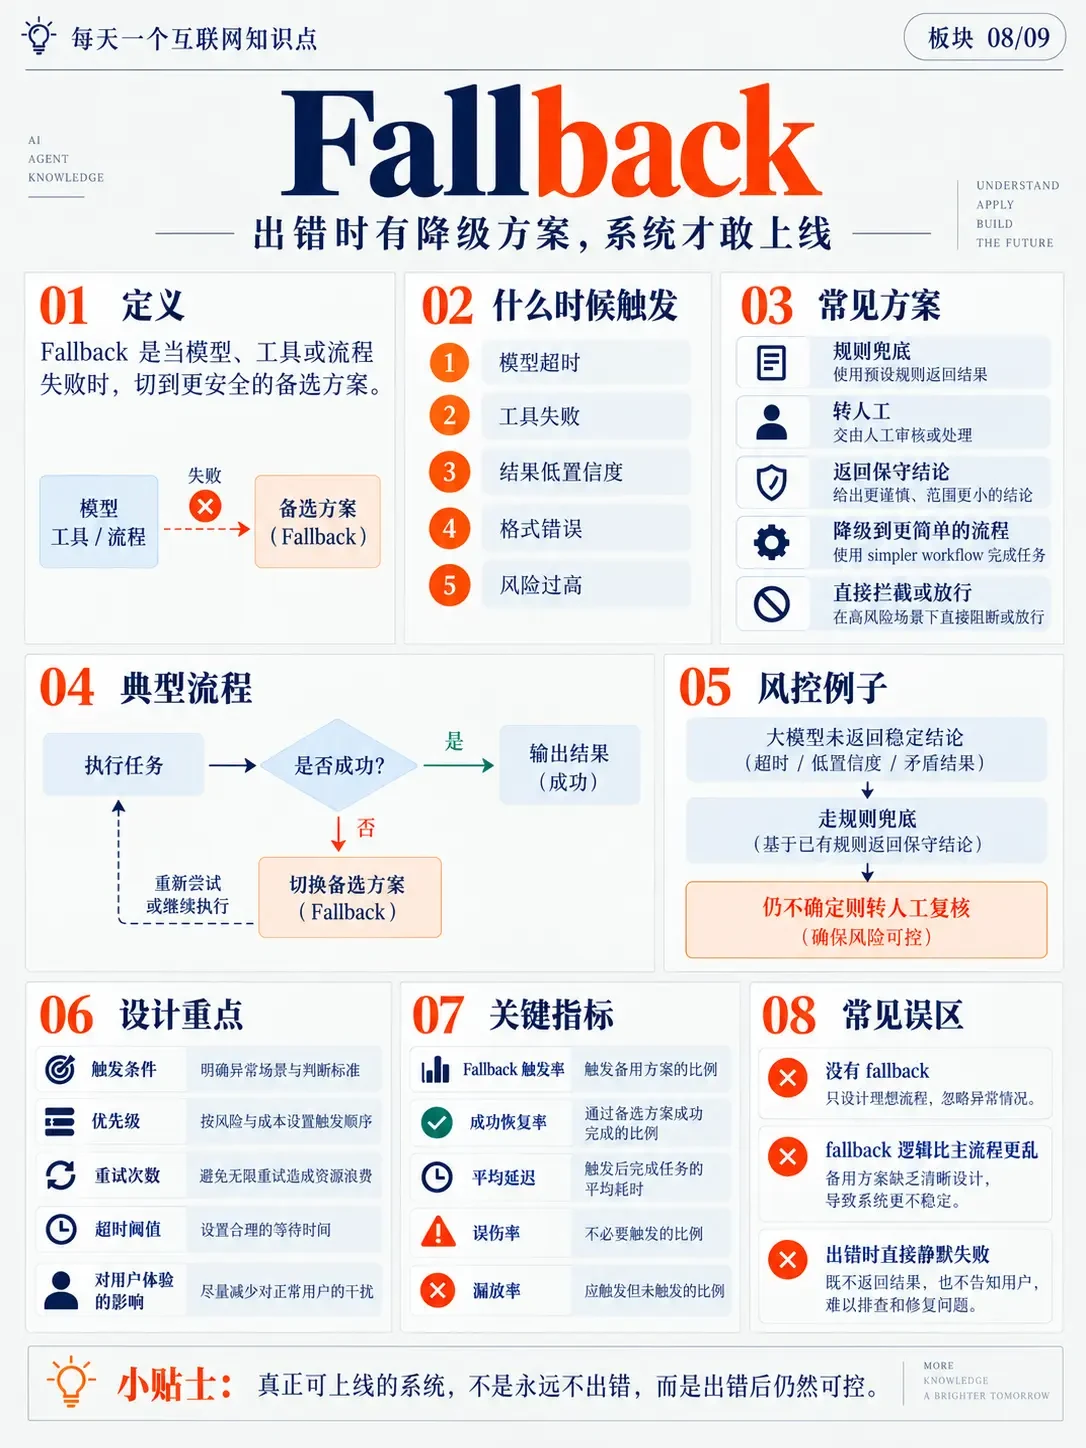
定义:当模型、工具或流程失败时,切到更安全的备选方案,让系统才敢上线。
什么时候触发:模型超时、工具失败、结果低置信度、格式错误、风险过高。
常见方案:规则兜底(使用预设规则返回结果)、转人工(交由人工审核)、返回保守结论(更谨慎、范围更小)、降级到更简单流程、直接拦截或放行(高风险阻断)。
典型流程:执行任务 → 是否成功?→ 成功输出;失败→(超时/低置信度)走规则兜底 → 重试或切换备选 → 仍不确定则转人工复核。
设计重点:触发条件(明确异常与判断标准)、优先级(按风险与成本设置触发顺序)、重试次数(避免无限重试)、超时阈值、对正常用户的影响(尽量减少干扰)。
关键指标:Fallback 触发率、成功恢复率、平均延迟、误伤率(不必要触发比例)、漏放率(应触发未触发比例)。
常见误区:没有 fallback(只设计理想流程)、fallback 逻辑比主流程更乱(备用方案缺乏清晰设计)、出错时直接静默失败(既不返回也不告知,难排查)。
真正可上线的系统,不是永远不出错,而是出错后仍然可控。
九、Permission / Audit Log(权限与审计)
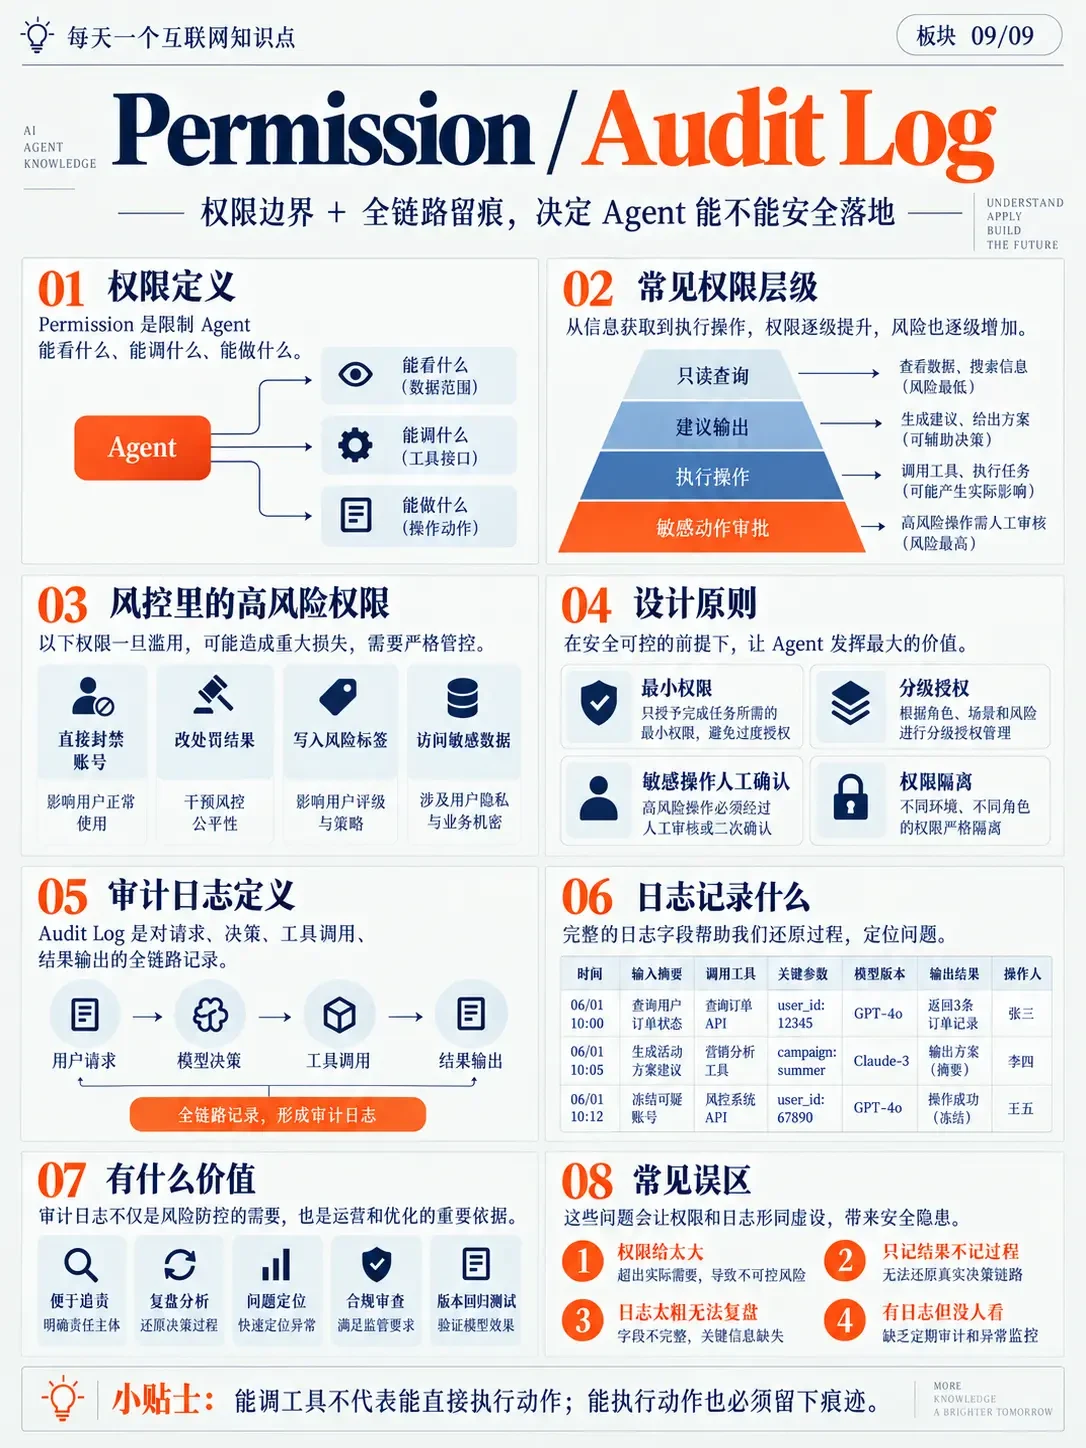
定义:Permission 限制 Agent 能看什么、能调什么、能做什么;Audit Log 对请求、决策、工具调用、结果输出做全链路记录。
常见权限层级(风险逐级增加):
- 只读查询(查看数据、搜索信息)— 风险最低
- 建议输出(生成建议、给方案)— 可辅助决策
- 执行操作(调用工具、执行任务)— 产生实际影响
- 敏感动作审批(高风险需人工审核)— 风险最高
设计原则:最小权限、分级授权(按角色/场景/风险)、敏感操作人工确认、权限隔离(不同环境/角色严格隔离)。
审计日志记录什么:时间、输入需求、调用工具、关键参数、模型版本、输出结果、操作人 —— 全链路记录,可还原决策过程。
日志价值:便于追责(明确责任主体)、复盘分析(还原决策过程)、问题定位(快速定位异常)、合规审查(满足监管)、版本回归测试(验证模型效果)。
常见误区:权限给太大(不可控风险)、只记结果不记过程(无法还原决策链路)、日志太粗(字段不完整)、有日志但没人看(缺乏定期审计与监控)。
能调工具不代表能直接执行动作;能执行动作也必须留下痕迹。
📚 相关笔记
- 看完这条:AI 七层全貌 — 从七层体系理解 Agent 所处位置
- 第13集:手搓 Agent vs LangChain — 基础概念的面试应用
- Agent 结构化输出与工具调用(Function Calling / Tool Use / MCP / 校验) — 结构化输出与工具调用落地
- AI 大模型 MOC