知识库高效召回方法:从 Multi-Query 到 Hybrid + Reranker 的 RAG 演进
图文帖转录 + 整理 · 来源:抖音 AI-The-Matrix · 知识库高效召回方法
以下内容依据原图文帖 6 张配图 OCR 整理,保留全部原文配图。图中个别文字 OCR 有误(如”检素→检索、FAISs→FAISS”等),已在正文按语义校正。
0. 一句话总览
这是一套银行制度 PDF 智能问答系统的检索增强(RAG)方案设计。全文 6 张图恰好是一条「知识库高效召回」的逐级增强演进线:
Multi-Query 多查询扩展 → FAISS 向量检索 → Hybrid 混合检索(BM25 + 向量)→ Multi-Query 查询增强 → BGE Reranker 精排 → DeepSeek-V3 大模型生成
要解决的痛点:传统 RAG 用单一查询做检索,用户表达方式多样、关键词不准、隐藏语义难挖掘,导致召不回、召回错。逐级叠加模块,最终做到”召得全、排得准、答得可信、来源可追溯”。
1. 版本一:Multi-Query 多查询检索(DeepSeek + FAISS)
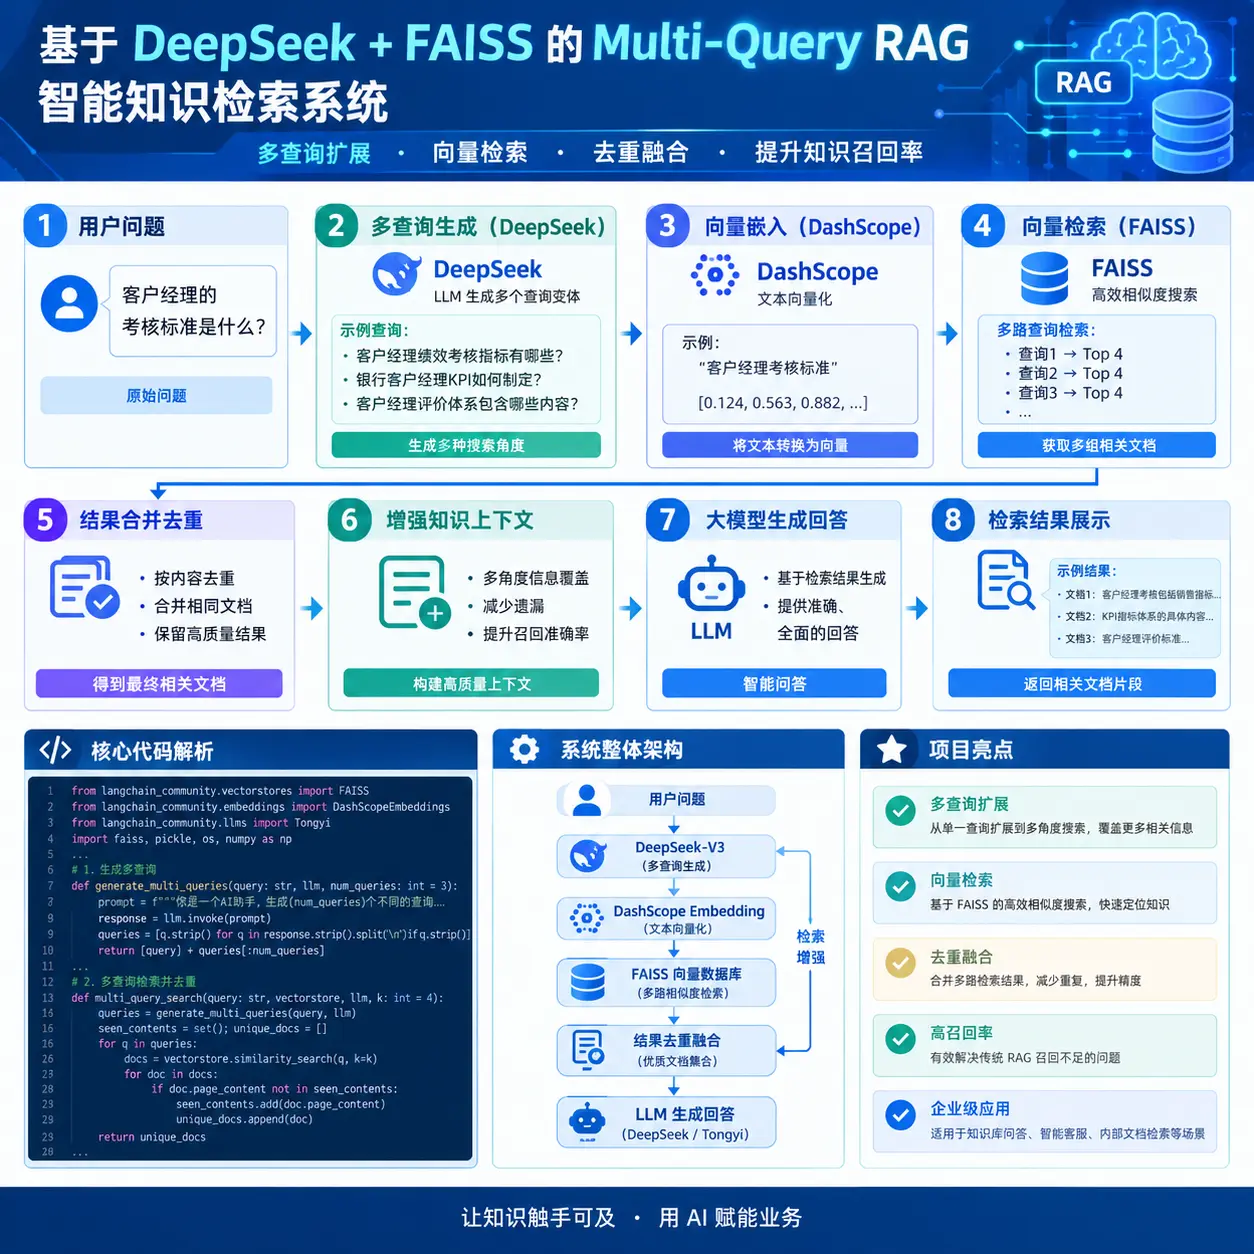
解决什么问题:单条查询角度单一 → 用大模型把一个问题改写成多个查询变体,从多角度检索,提升召回率、减少遗漏。
流水线:用户问题 → ①多查询生成(DeepSeek)→ ②向量嵌入(DashScope)→ ③向量检索(FAISS)→ ④结果合并去重 → ⑤增强知识上下文 → ⑥大模型生成回答。
示例(客户经理考核):
| 原始问题 | 生成的多路查询 | 检索 |
|---|---|---|
| ”客户经理考核标准是什么?“ | 查询1:客户经理绩效考核指标有哪些? | Top4 |
| ↑ | 查询2:银行客户经理 KPI 如何制定? | Top4 |
| 查询3:客户经理评价体系包含哪些内容? | Top4 |
多路结果按内容去重合并:合并相同文档、减少遗漏、保留高质量结果、提升召回准确率,最终构建高质量上下文供 LLM 生成全面回答。
2. 版本二:PDF 制度问答 ·「离线建库 + 在线问答」双流程
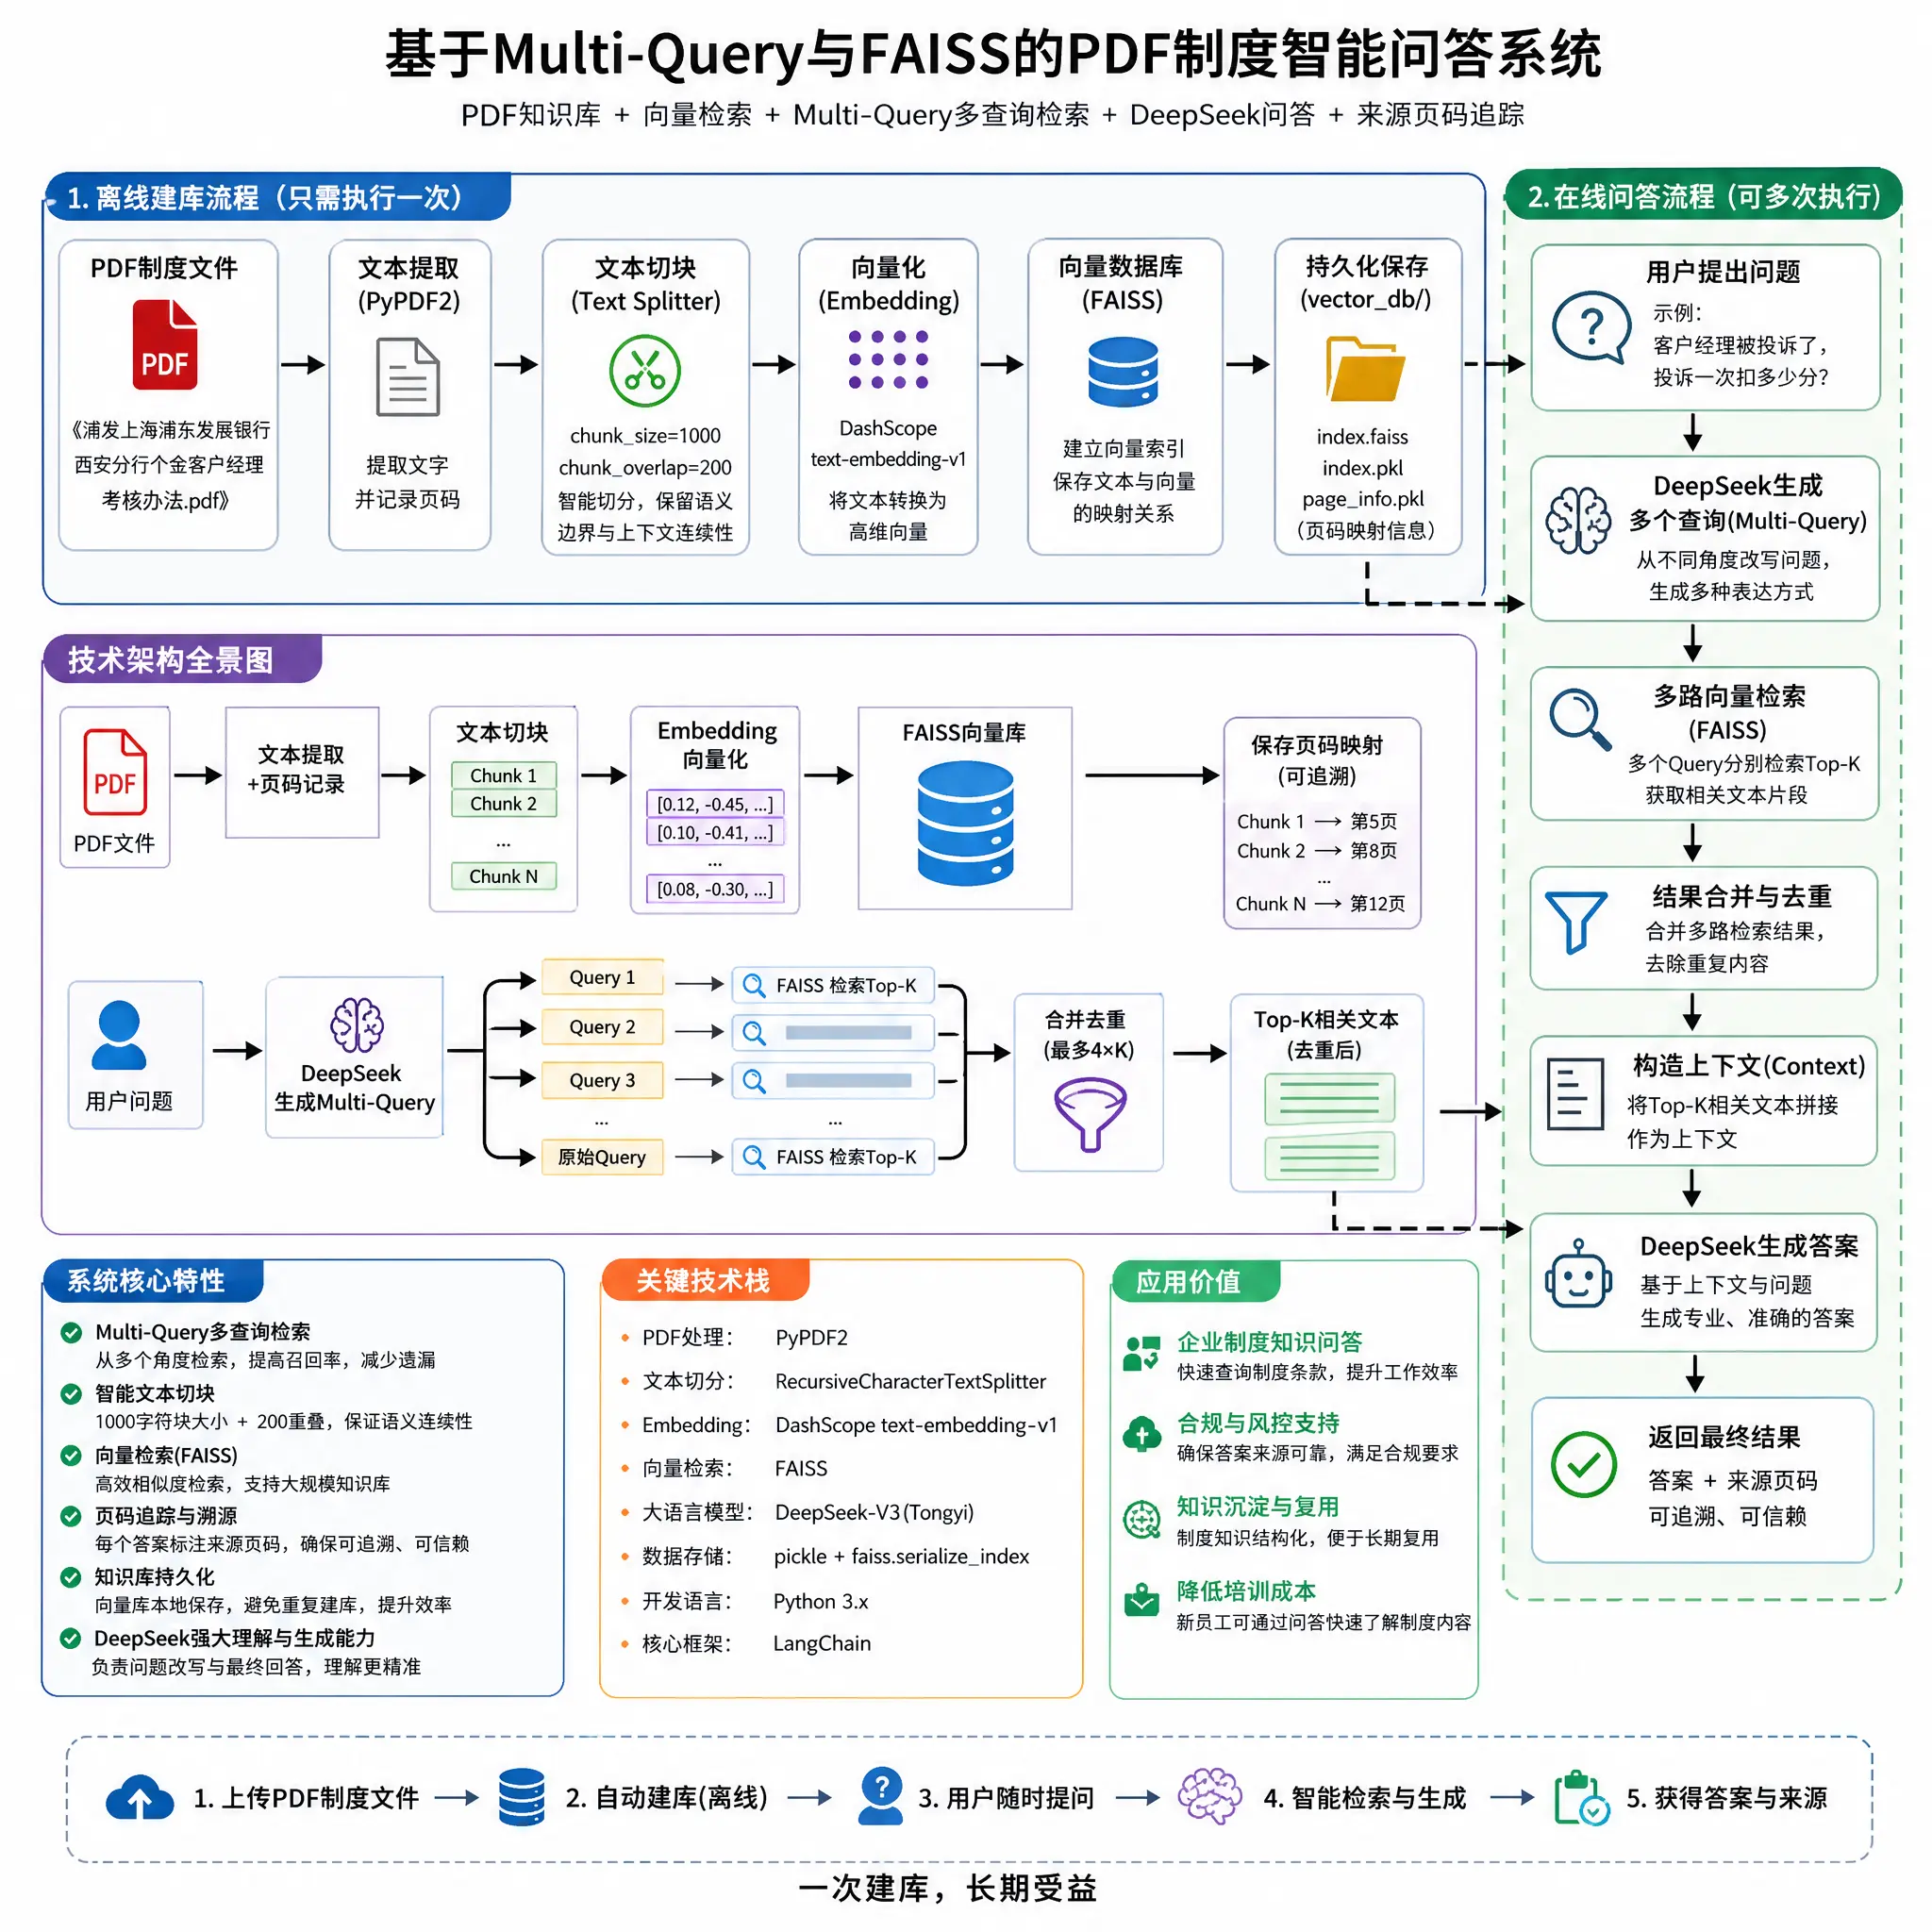
在 Multi-Query 基础上补全知识库建库与问答两条完整流程,并以”浦发银行《西安分行个金客户经理考核办法.pdf》“为案例。
① 离线建库流程(只需执行一次):
PDF 制度文件 → 文本提取(PyPDF2)→ 文本切块(chunk_size=1000,chunk_overlap=200,保留语义边界)→ 向量化(DashScope text-embedding-v1)→ FAISS 向量数据库 → 持久化保存(vector_db/:index.faiss 向量索引、index.pkl 文本与向量、page_info.pkl 页码映射)。
② 在线问答流程(可多次执行):
用户提问 → 生成 Multi-Query 多路查询 → 每路 FAISS 检索 Top-K(最多 4×K)→ 合并去重 → 拼装上下文 → DeepSeek 生成答案+来源页码(如 Chunk1→第5页、ChunkN→第12页)。
关键技术栈:PDF 处理 PyPDF2 · 文本切分 RecursiveCharacterTextSplitter · Embedding DashScope · 向量检索 FAISS · 大模型 DeepSeek-V3(/Tongyi)· 持久化 pickle + faiss.serialize_index · 开发语言 Python 3.x · 核心框架 LangChain。
增量价值:一次建库,长期受益——向量库本地保存,下次直接加载,速度从分钟级降到秒级。
3. 版本三:Hybrid 混合检索原理(FAISS 向量 + BM25 关键词)
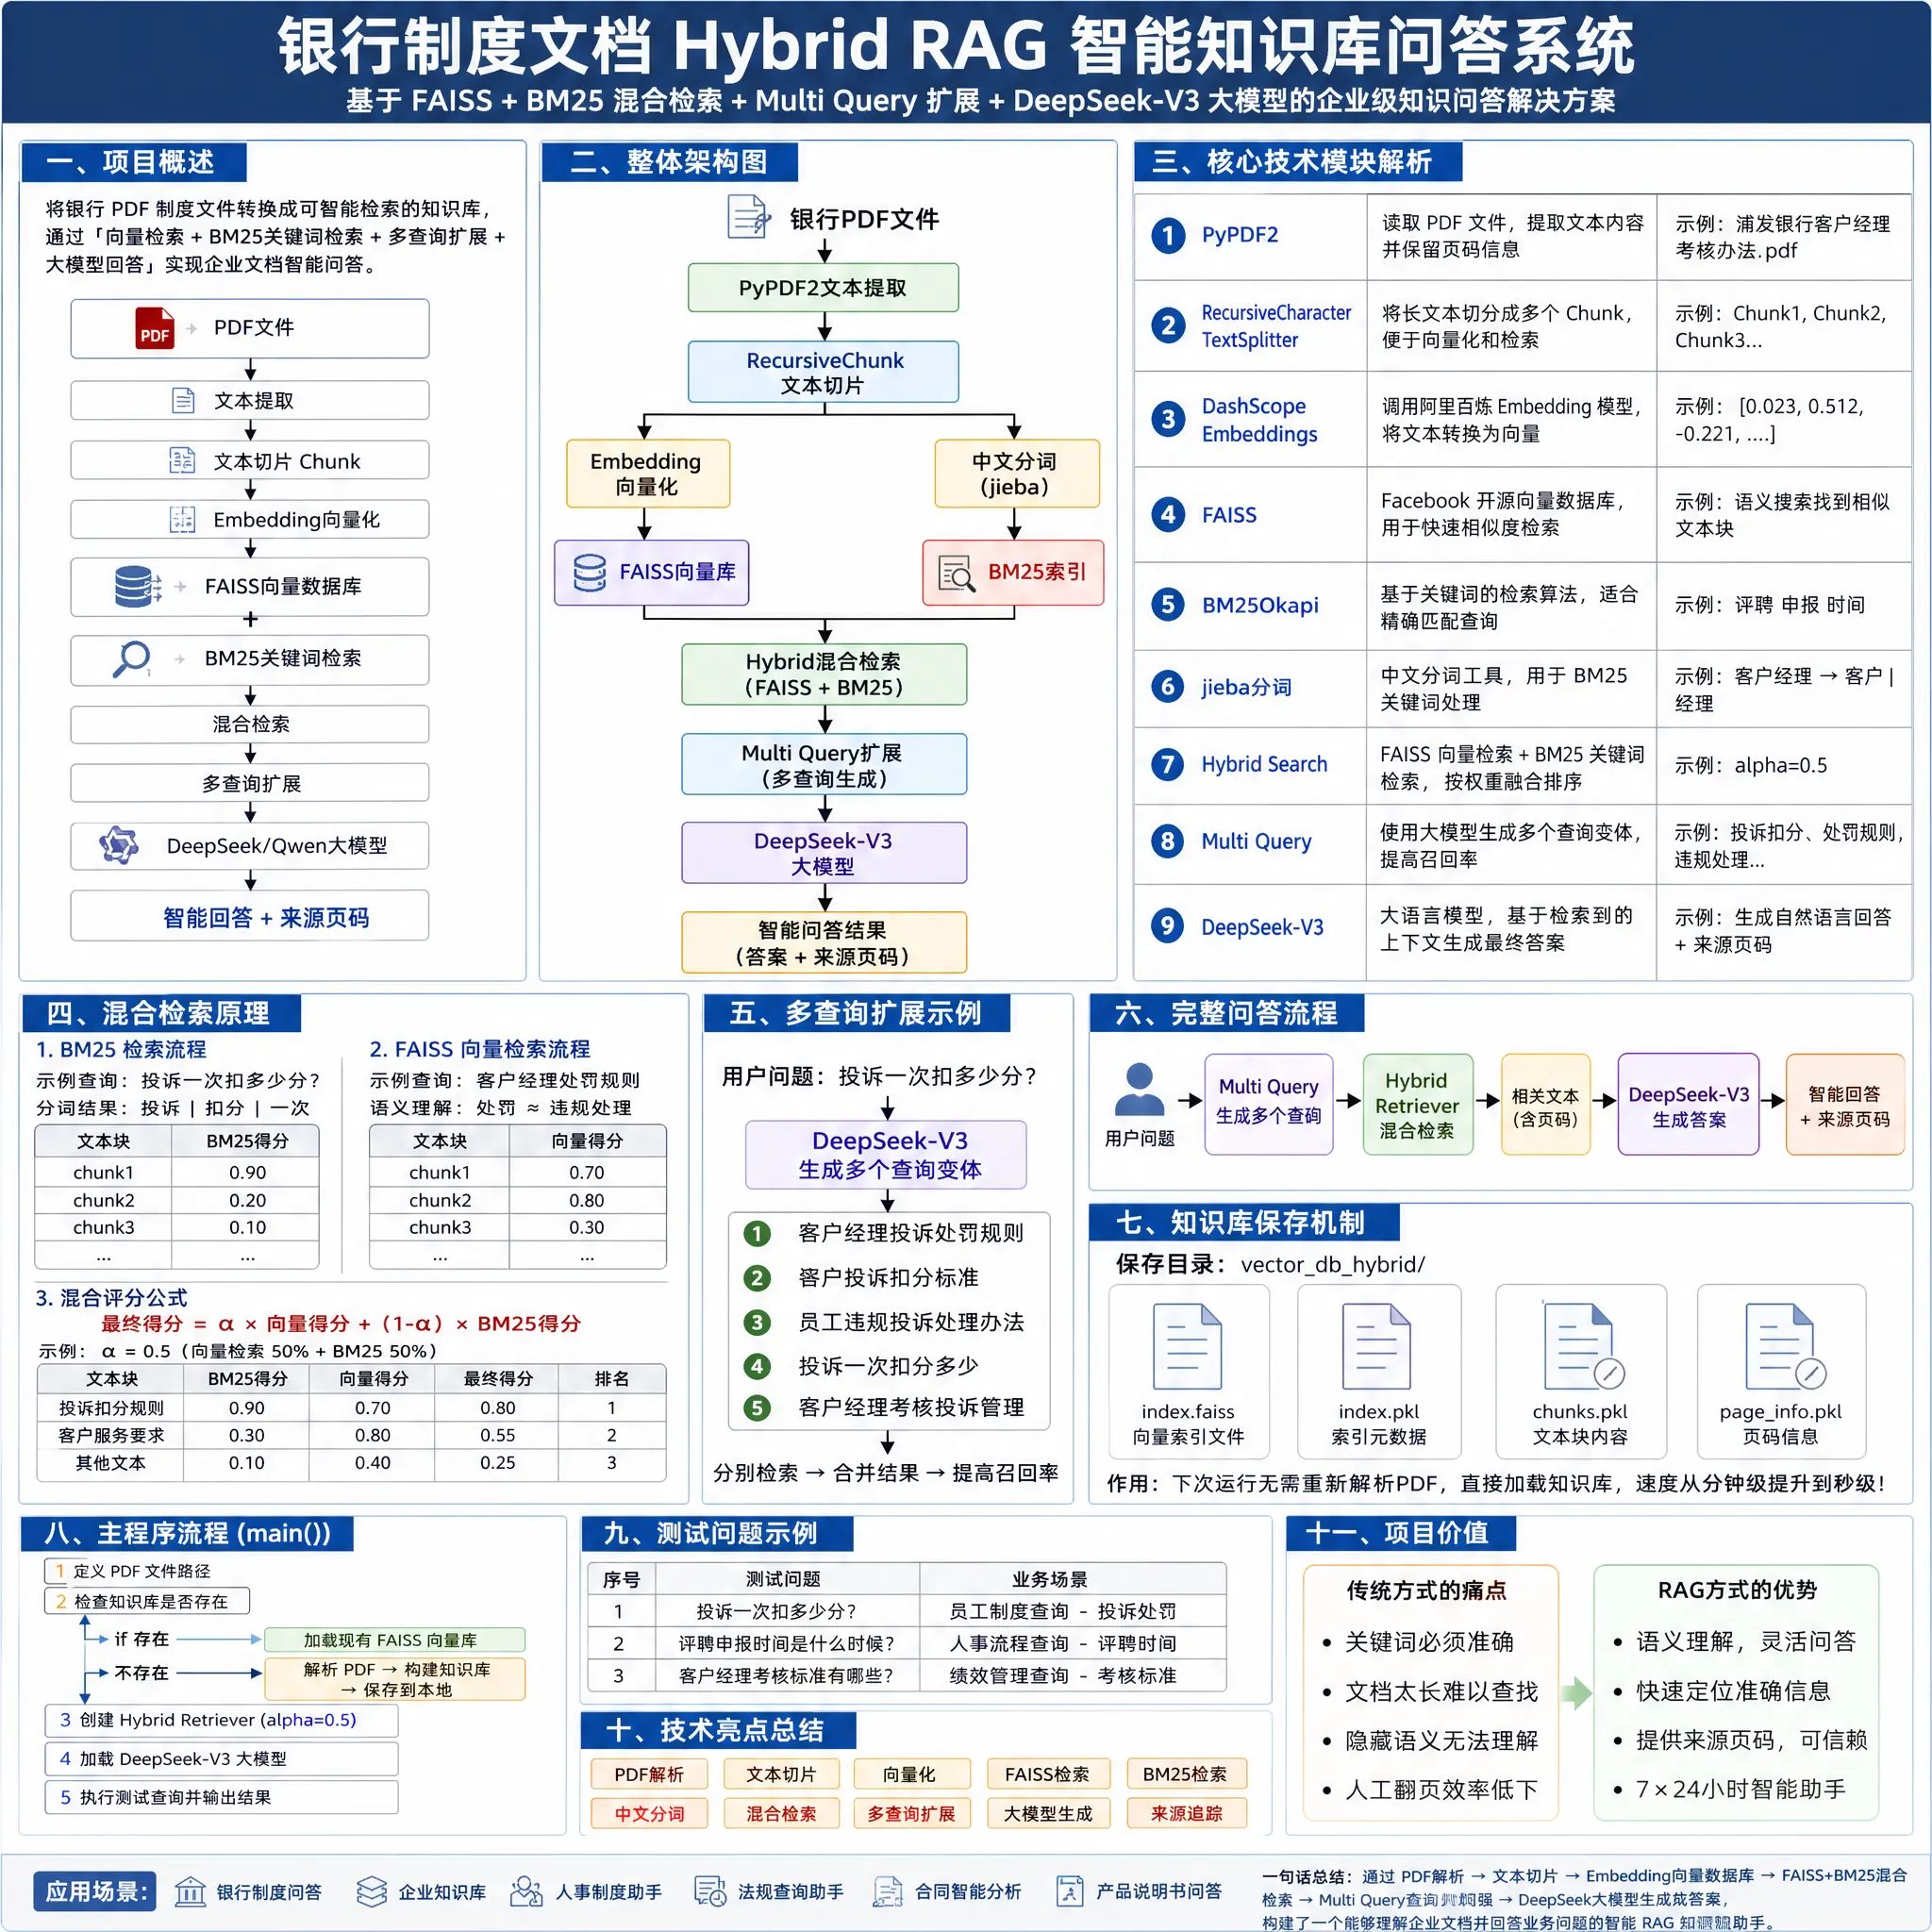
纯向量检索忽略了精确关键词匹配。此版引入 BM25 关键词检索 + jieba 中文分词,与 FAISS 向量检索按权重融合排序。
混合检索机制:
- BM25 路径:jieba 中文分词 → rank_bm25 精确匹配 → 适合”评聘申报时间”这类精确查询。
- 向量路径:DashScope Embedding → FAISS 相似度检索 → 适合语义理解。
- 融合公式(核心):
示例(α=0.5) 最终得分排名:
| 文本块 | BM25 | 向量 | 最终 | 排名 |
|---|---|---|---|---|
| 投诉扣分规则 | 0.90 | 0.70 | 0.80 | 1 |
| 客户经理考核投诉管理 | 0.30 | 0.80 | 0.55 | 2 |
| 客户服务要求 | 0.10 | 0.40 | 0.25 | 3 |
知识库保存(vector_db_hybrid/):index.faiss + index.pkl + chunks.pkl + page_info.pkl——下次运行无需重新解析 PDF,加载即用,分钟级 → 秒级。
主程序流程(main):定义 PDF 路径 → 检查知识库是否存在(存在:加载现有 FAISS 库;不存在:解析 PDF 建库并保存)→ 创建 HybridRetriever(alpha=0.5)→ 加载 DeepSeek-V3 → 执行测试查询并输出结果。
4. 版本四:SmartBankRAG 2.0 架构(企业级知识助手)
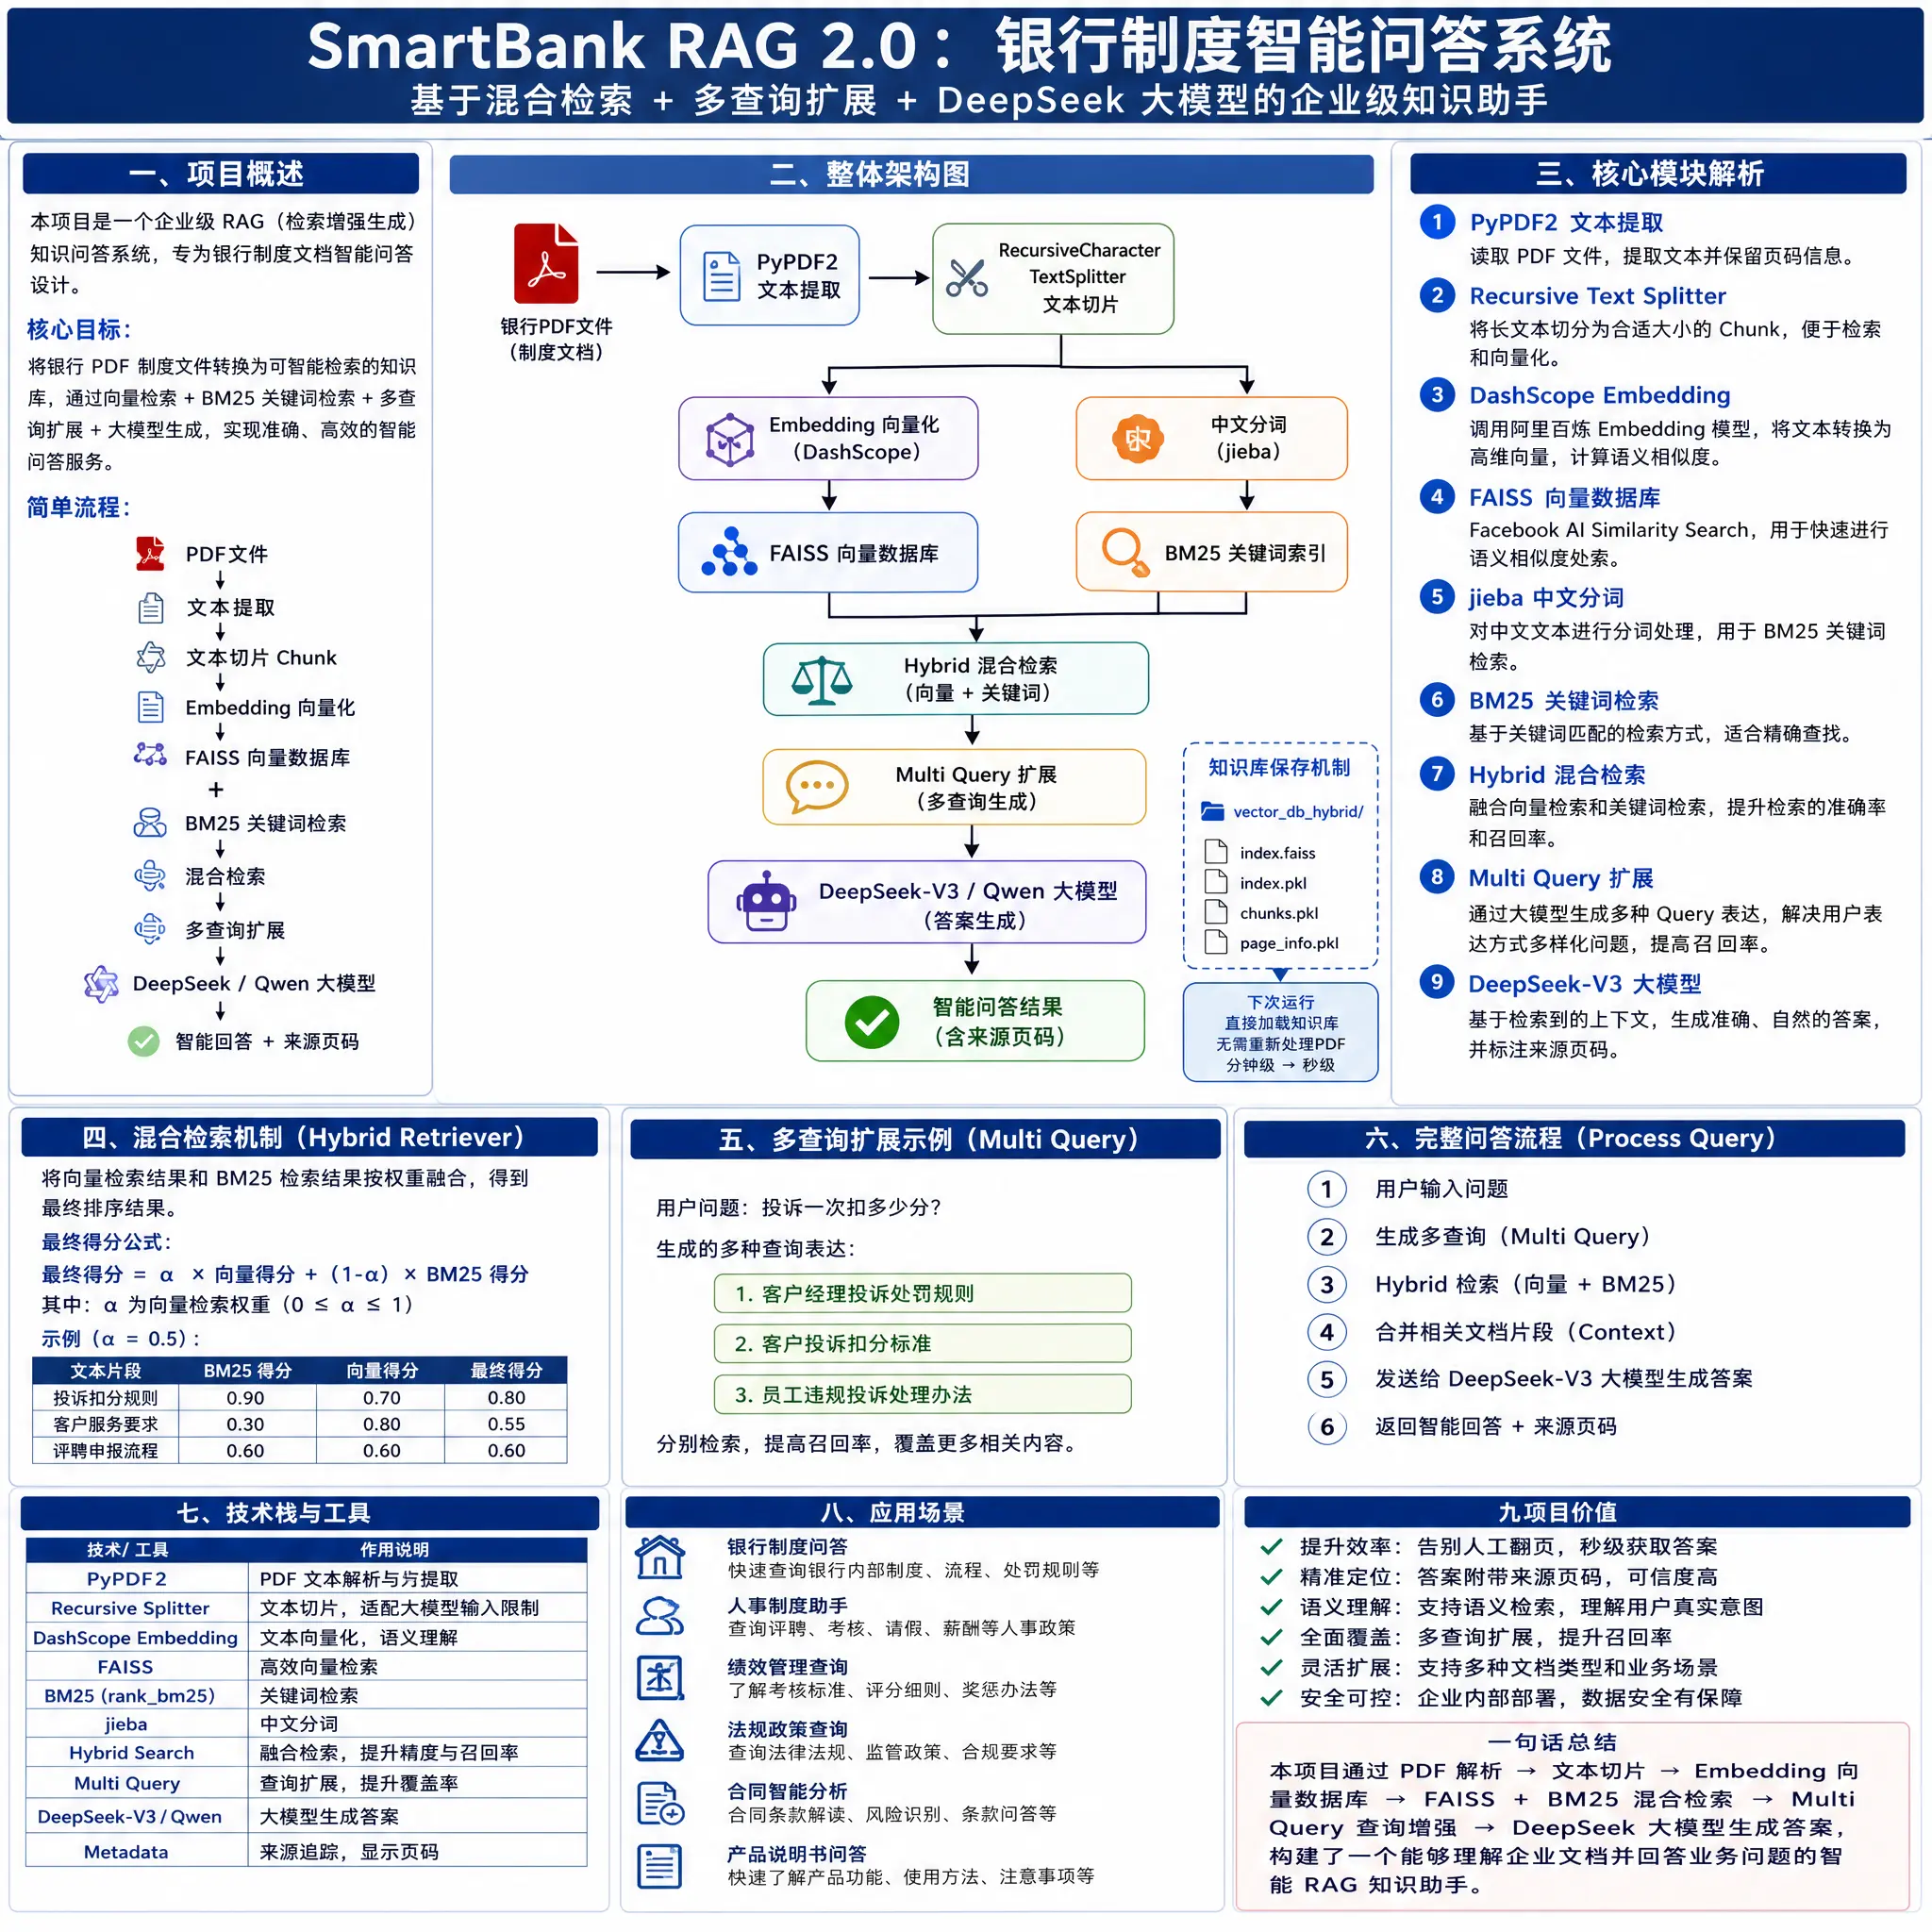
把前面版本系统化成企业级架构,逐模块拆解:
核心模块:PyPDF2 文本提取(保留页码)→ RecursiveTextSplitter 文本切片 → DashScope Embedding 向量化(+jieba 中文分词)→ FAISS 向量库 + BM25 关键词索引 → Hybrid 混合检索 → Multi-Query 扩展 → DeepSeek-V3/Qwen 生成(含来源页码)。
完整问答流程(Process Query):用户输入问题 → 生成多查询(Multi-Query)→ Hybrid 检索(向量+BM25)→ 合并相关文档片段(Context)→ 发送 DeepSeek-V3 生成答案 → 返回智能回答+来源页码。
技术栈与作用:
| 技术/工具 | 作用 |
|---|---|
| PyPDF2 | PDF 文本解析与块提取 |
| RecursiveSplitter | 文本切片,适配大模型输入限制 |
| DashScopeEmbedding | 文本向量化、语义理解 |
| FAISS | 高效向量检索 |
| BM25(rank_bm25) | 关键词检索 |
| jieba | 中文分词 |
| Hybrid Search | 融合检索,提升精度与召回 |
| MultiQuery | 查询扩展,提升覆盖率 |
| DeepSeek-V3/Qwen | 大模型生成答案 |
| Metadata | 来源追踪、显示页码 |
5. 版本五:企业文档智能问答总览
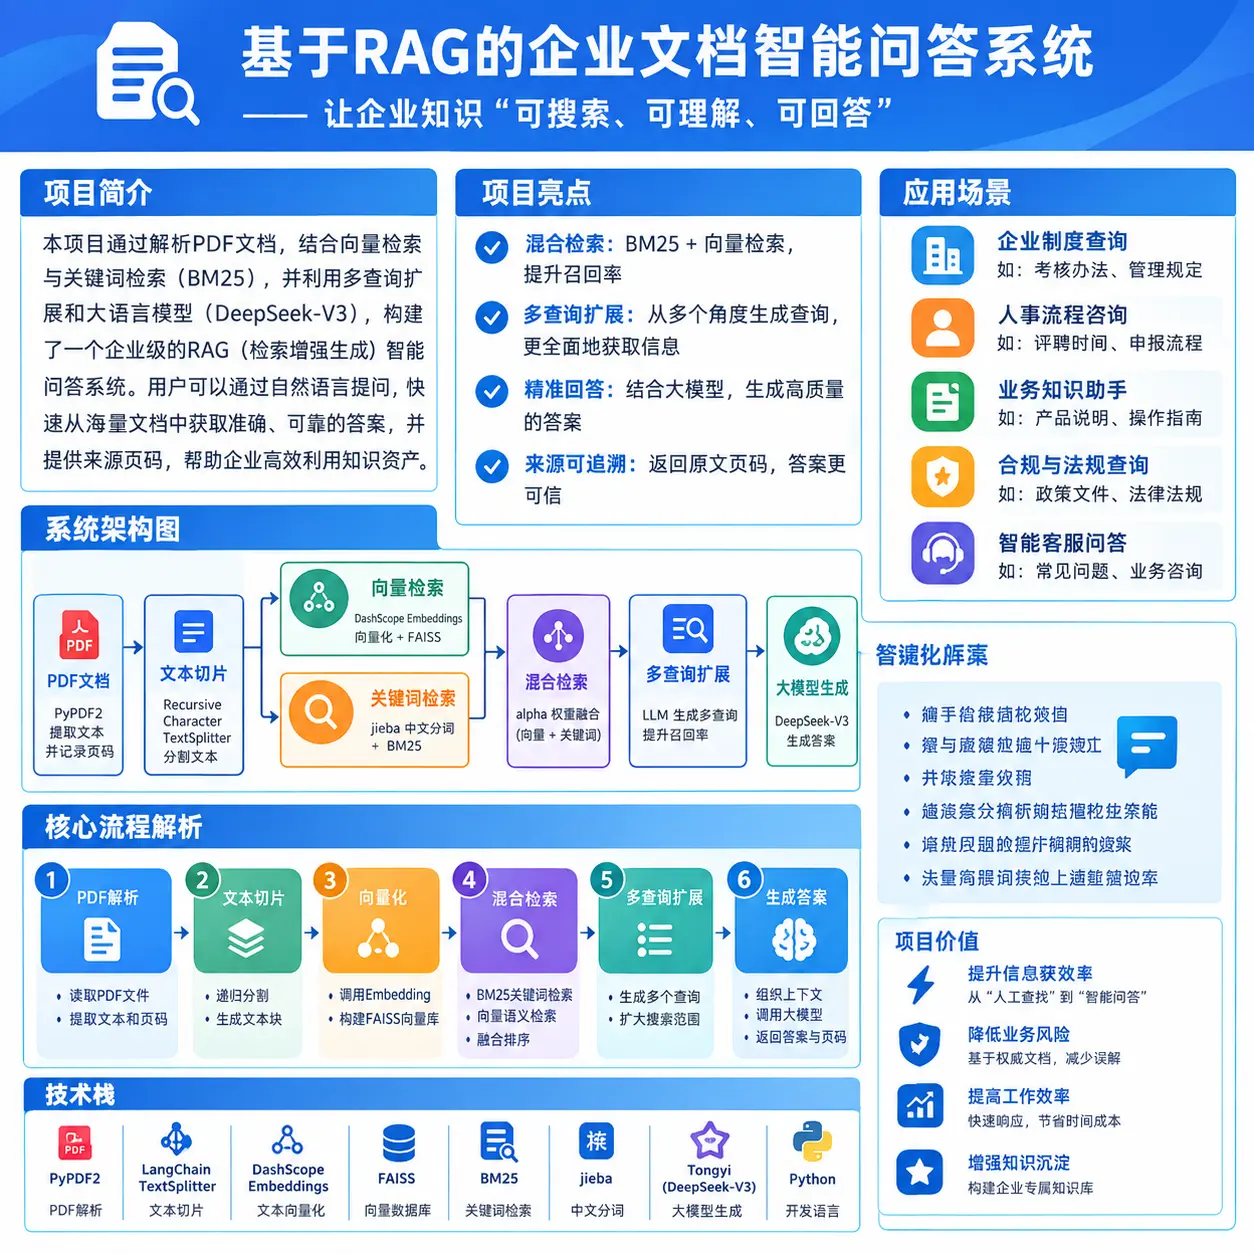
一页对外汇报总览,把系统价值讲清楚——“让企业知识可搜索、可理解、可回答”。
项目亮点:① 混合检索(BM25+向量)提升召回率;② 多查询扩展从多角度生成查询、更全面获取信息;③ 大模型精准回答;④ 来源页码可追溯、答案更可信。
系统架构一行流:PDF 文档 → 文本切片(PyPDF2+RecursiveCharacterTextSplitter)→ 向量化+FAISS → 混合检索(向量+BM25,alpha 权重融合,jieba 分词)→ 多查询扩展(LLM 生成多查询,提升召回率)→ DeepSeek-V3 生成答案。
核心流程解析:PDF 解析(读取、提取文本和页码)→ 文本切片(递归分割、生成文本块)→ 向量化(调用 Embedding、构建 FAISS 库)→ 混合检索(BM25 关键词 + 向量语义检索、融合排序)→ 多查询扩展(生成多个查询、扩大搜索范围)→ 生成答案(组织上下文、调用大模型、返回答案与页码)。
应用场景:企业制度查询(考核办法、管理规定)· 人事流程咨询(评聘时间、申报流程)· 业务知识助手(产品说明、操作指南)· 合规与法规查询(政策文件、法律法规)· 智能客服问答(常见问题、业务咨询)。
6. 版本六:加入 Reranker 精排(BGE 重排序)
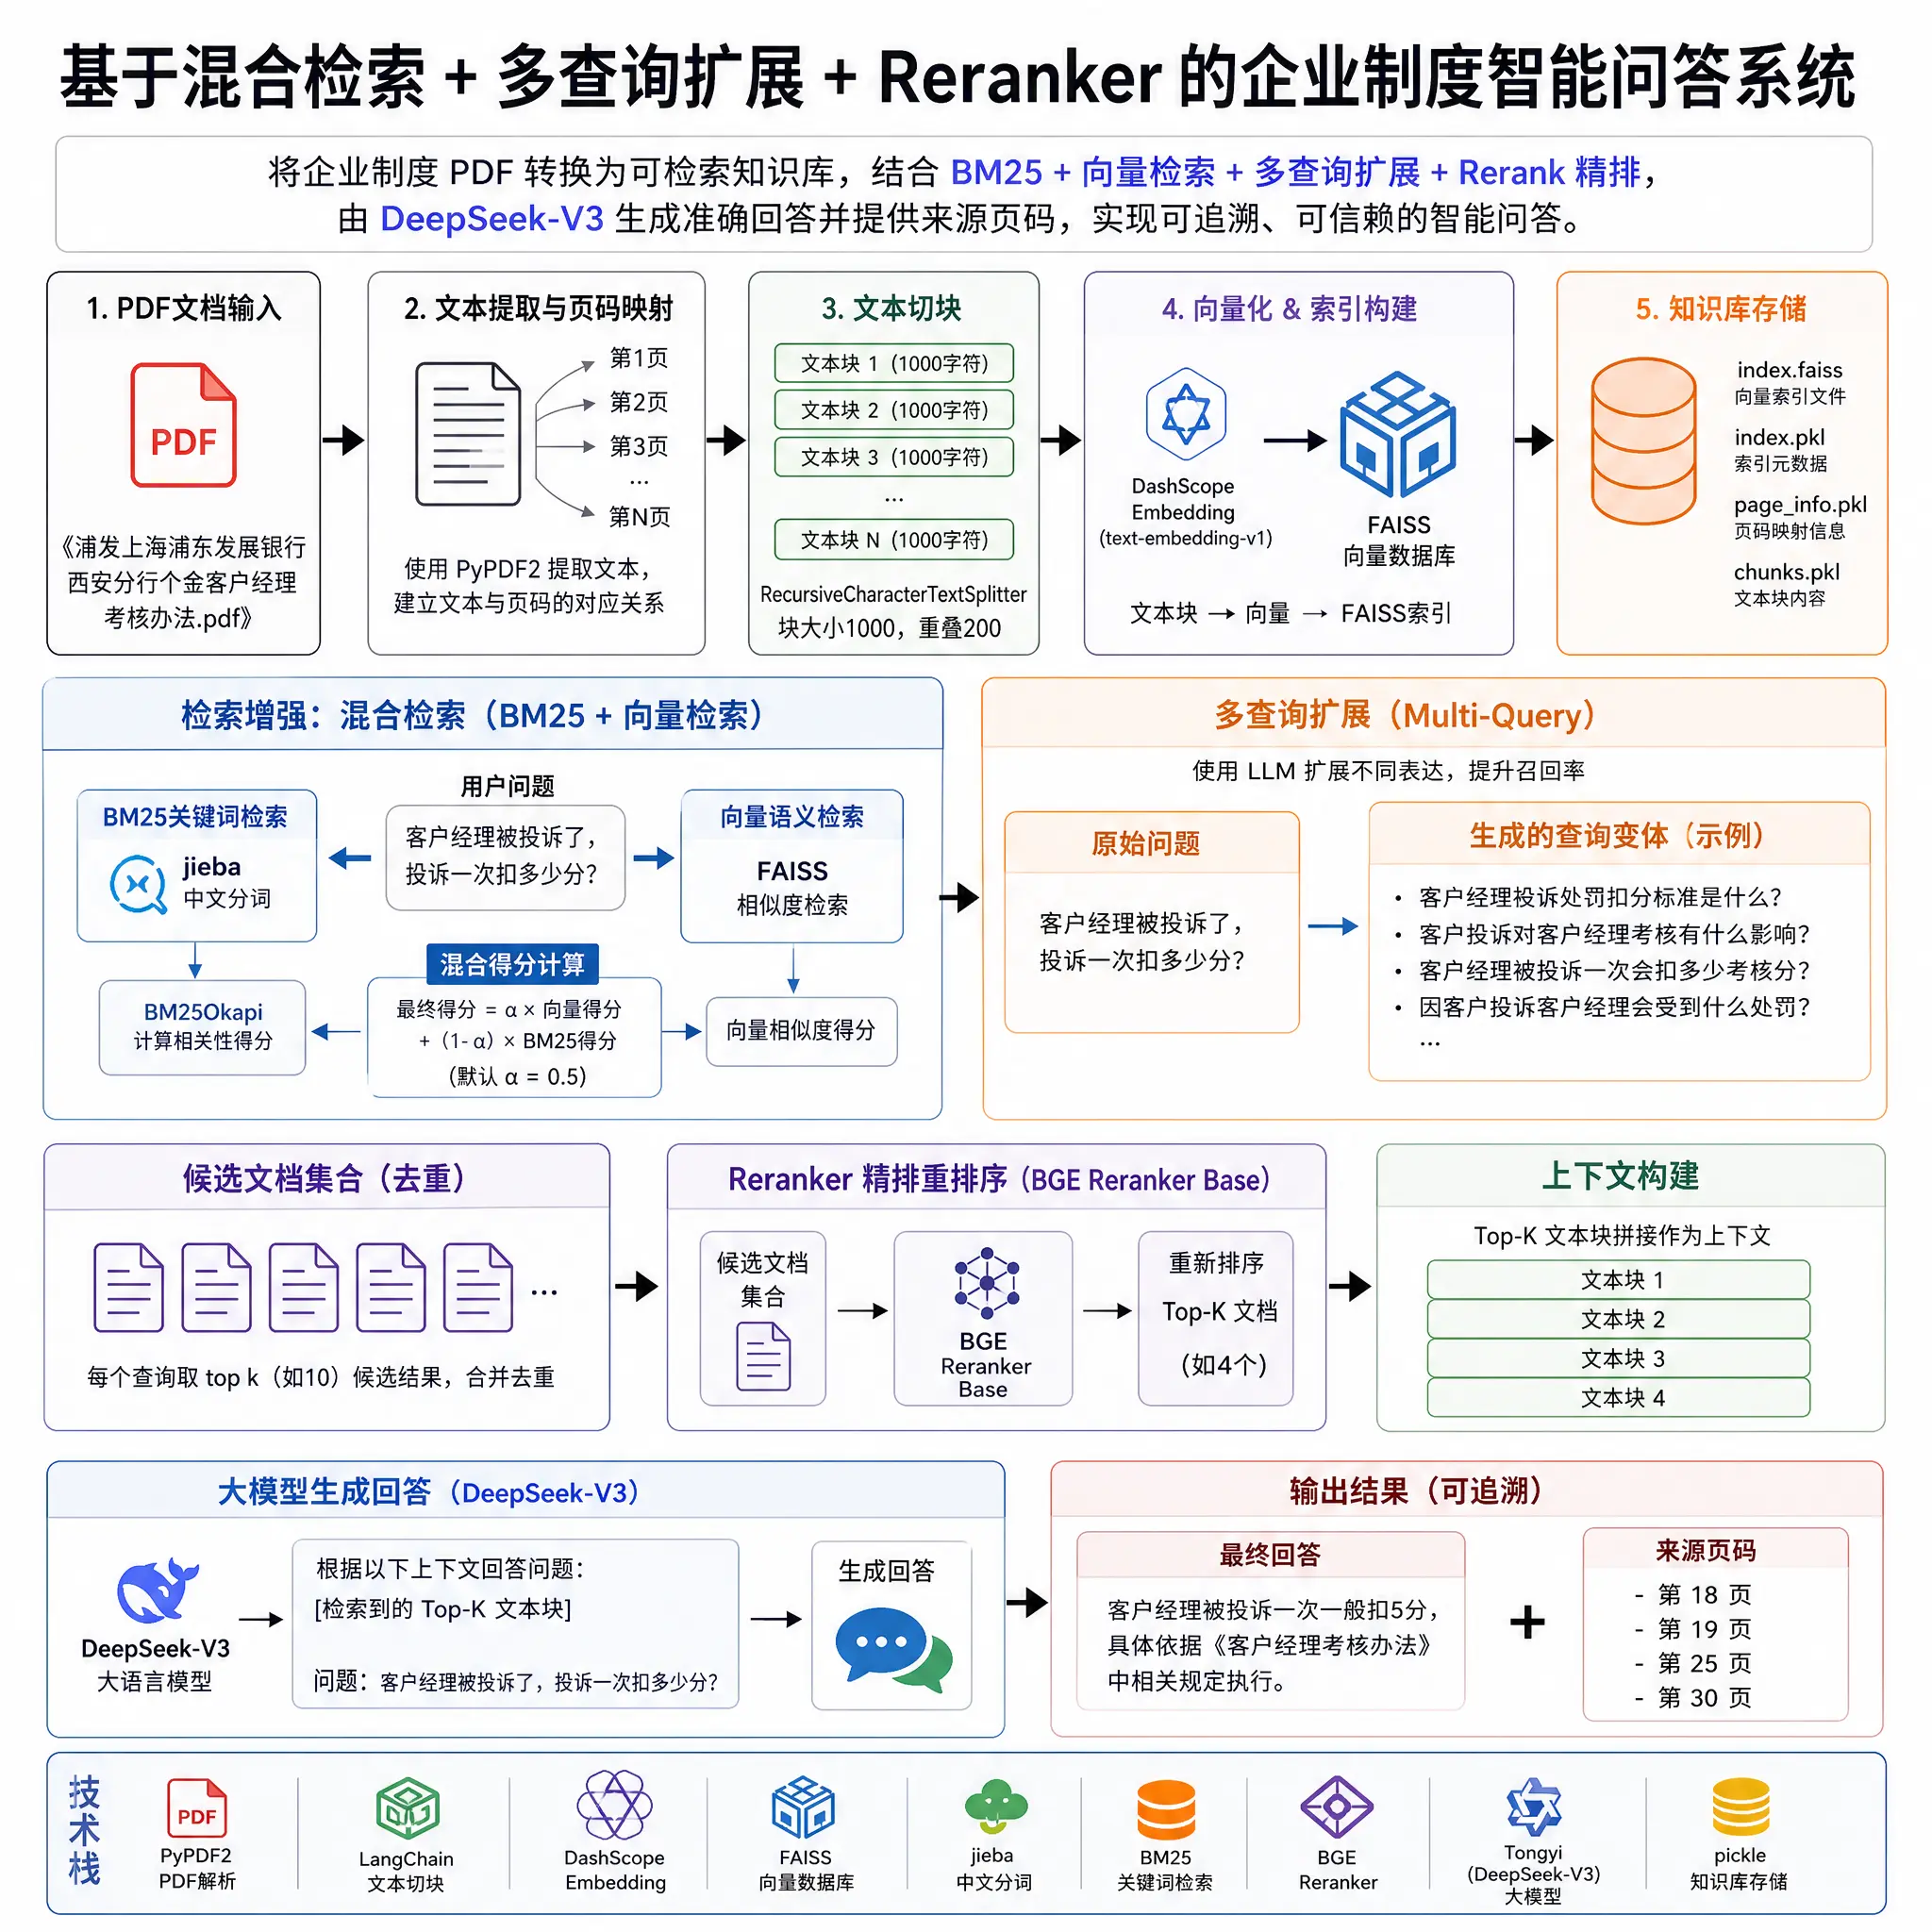
最后一块拼图:混合检索出的候选仍是粗排,此版加 BGE Reranker(bge-reranker-base) 做精排重排序,让最相关的文档排在前面,提高回答质量。
检索增强链路:用户问题 → 原始问题 → ① BM25 关键词检索(jieba 分词)+ ② 向量语义检索(FAISS)→ 混合得分计算(最终得分=α×向量得分+(1-α)×BM25得分,默认 α=0.5)→ 候选文档集合(去重)(每查询取 Top-K≈10 候选,合并去重)→ BGE Reranker 精排(Top-K 文档,如精排到 4 个)→ 上下文构建(Top-K 文本块拼接)→ DeepSeek-V3 生成回答 → 输出(最终回答 + 来源页码,如”客户经理被投诉一次一般扣5分,依据《客户经理考核办法》…”—第18/19页)。
建库细节(浦发《个金客户经理考核办法.pdf》):
- 文本提取:PyPDF2,建立文本与页码的对应关系;
- 文本切块:RecursiveCharacterTextSplitter,块大小 1000、重叠 200;
- 向量化&索引:DashScope
text-embedding-v1→ 文本块→向量→FAISS 索引; - 存储:
index.faiss(向量索引)+index.pkl(索引元数据)+chunks.pkl(文本块内容)+page_info.pkl(页码映射)。
7. 核心技术要点 · 一图纵览演进
| 增强手段 | 解决的问题 | 关键技术 | 状态 |
|---|---|---|---|
| Multi-Query 扩展 | 单查询召回不足 | DeepSeek 改写多路查询 | 通用 RAG |
| 向量检索 | 语义相似 | DashScope + FAISS | 建库基础 |
| Hybrid 混合检索 | 关键词精确匹配丢失 | BM25 + jieba + α 融合 | 检索增强 |
| Reranker 精排 | 粗排不精 | BGE-Reranker-Base | 精排增强 |
| 大模型生成 | 答案质量 | DeepSeek-V3 / Qwen | 生成端 |
| 来源页码追踪 | 答案可信、可追溯 | page_info 映射 | 全链路 |
一句话总结:通过 PDF 解析 → 文本切片 → Embedding 向量数据库 → FAISS+BM25 混合检索 → MultiQuery 查询增强 →(Reranker 精排)→ DeepSeek 大模型生成答案,构建了一个能理解企业文档并回答业务问题的智能 RAG 知识助手。
8. 核心代码(依据图1 OCR 整理)
下方代码为按图面 OCR 语义校正后的示例实现,函数名与逻辑忠实于原图;变量/全角括号等 OCR 噪声已修正,建议对照原图校验细节。
import faiss, pickle, os, numpy as np
from langchain_community.vectorstores import FAISS
from langchain_community.embeddings import DashScopeEmbeddings
from langchain_community.llms import Tongyi

# 1. 生成多查询(Multi-Query):把一个问题改写成多个角度
def generate_multi_queries(query: str, llm, num_queries: int = 3):
    prompt = f"你是一个AI助手,生成{num_queries}个不同的查询…"
    response = llm.invoke(prompt)
    queries = [q.strip() for q in response.strip().split("\n") if q.strip()]
    return [query] + queries[:num_queries]

# 2. 多查询检索 + 去重:多路 Top-K 合并,去重后提升精度
def multi_query_search(query: str, vectorstore, llm, k: int = 4):
    queries = generate_multi_queries(query, llm)
    seen_contents, unique_docs = set(), []
    for q in queries:
        docs = vectorstore.similarity_search(q, k=k)
        for doc in docs:
            if doc.page_content not in seen_contents:
                seen_contents.add(doc.page_content)
                unique_docs.append(doc)
    return unique_docs
9. 去 OCR 原始逐图文字
如需逐字核对原图,六张图完整 OCR 见同目录图片或上方各节配图。本笔记已将碎片行重排为连贯叙述并保留原文配图。
相关笔记
- RAG检索策略全面解析 — 检索策略总览
- RAG检索可靠性系统设计 — 查询改写 → 混合检索 → 重排序 → 事实校验 全链路
- 混合检索排序方式 RRF — RRF 融合(对比本文的 α 加权融合)
- Cross Encoder(交叉编码器) — 精排模型(对比 BGE Reranker)
- ColBERT深度解析 — Token 级精排
- RAG 中的分块策略 — 本文 chunk_size=1000 / overlap=200 的取值依据
- AI 大模型 MOC — RAG 主题内容地图