Harness 五要素面试题(字节)· 精读笔记
视频转录 + 整理 · 来源:抖音 王二讲Agent · 字节面试题:Harness 的五要素是什么? · 时长 4:36
本文综合语音逐字稿与幻灯片 OCR,保留原文配图(视频实际画面截图)。人名/资料名(VILA-Lab、李博杰《深入理解 AI Agent》等)按原声记录。
0. 一句话答案(面试省流版)
回答 Harness 五要素时,千万不要答 Memory、Planning——那是 Agent 的能力维度,不是 Harness 的工程要素。
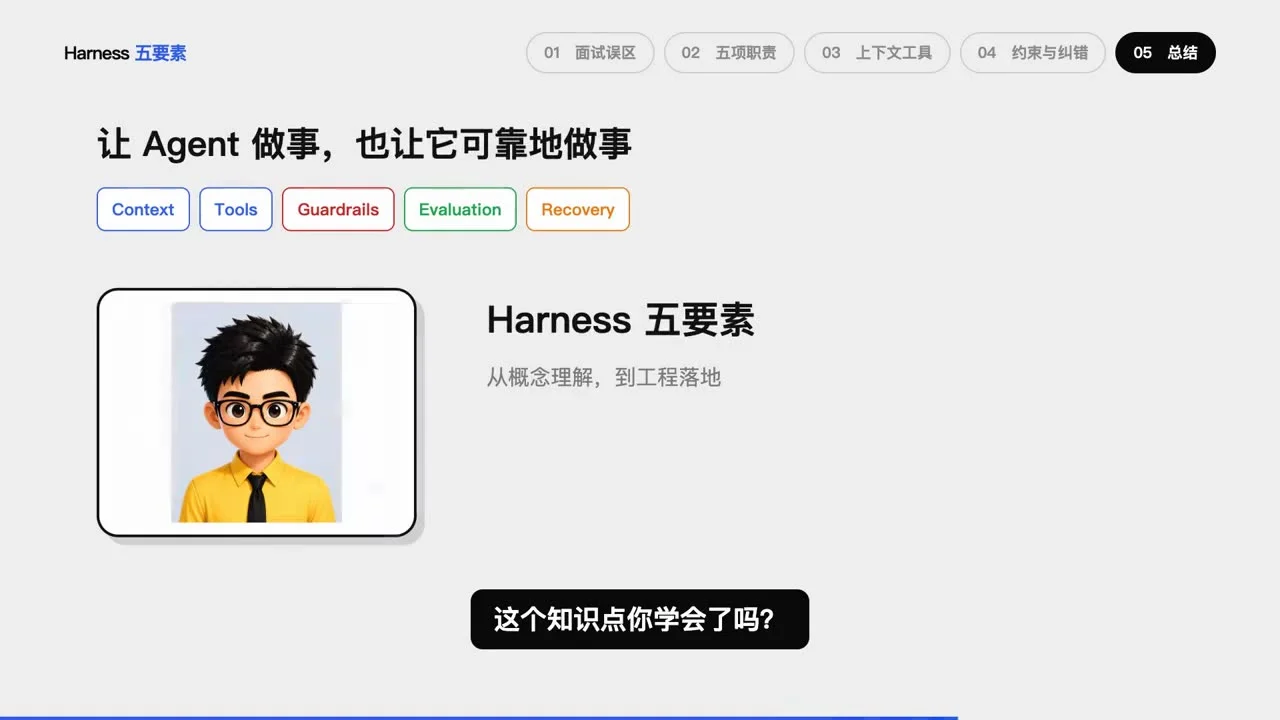
真正的五要素:Context(上下文)、Tools(工具调用)、Guardrails(约束)、Evaluation(验证)、Recovery(纠错)。
- 前两项(Context + Tools)管”能不能做事”
- 后三项(Guardrails + Evaluation + Recovery)管”能不能做错事、做错了怎么办”
面试金句:“Memory 最终是以上下文的形式进模型的,落脚点是 Context;Planning 只是一种计划模式。两者都是能力维度,真正的工程要素是另外那三项约束、验证、纠错。“
1. 面试避坑:为什么答 Memory / Planning 会出局
面试官问:“Harness 的五要素是什么?除了 Context 和 Tool Use,你还知道哪些?”
- 如果回答”还有 Memory 和 Planning”,恭喜你出门右拐回家等通知。
- 原因:Memory 和 Planning 是 Agent 的能力维度,不是 Harness 的工程要素。
- Memory → 以上下文形式进模型 → 落脚点是 Context
- Planning → 只是一种计划模式 → 落脚点是工作模式
- 真正让生产级 Agent 稳定运行的是另外三项约束:Guardrails、Evaluation、Recovery。
视频结构预告:
- Harness 是什么?五要素分别是什么?
- 各要素各管什么事、解决了什么问题?
- 工程上怎么落地?生产级代码怎么实现?
资料来源:VILA-Lab Claude Code 源码分析论文、李博杰《深入理解 AI Agent》。
2. 核心定义:Agent = Model + Harness
- Harness 本义:马具(缰绳、马鞍)。
- 大模型像爆发力极强的野马——能力强大,但需要可控的运行环境;套上缰绳马鞍,才能在受控轨道上全速奔跑。
- Agent = Model + Harness
- Model:负责推理
- Harness:模型之外 Agent 的运行治理环境
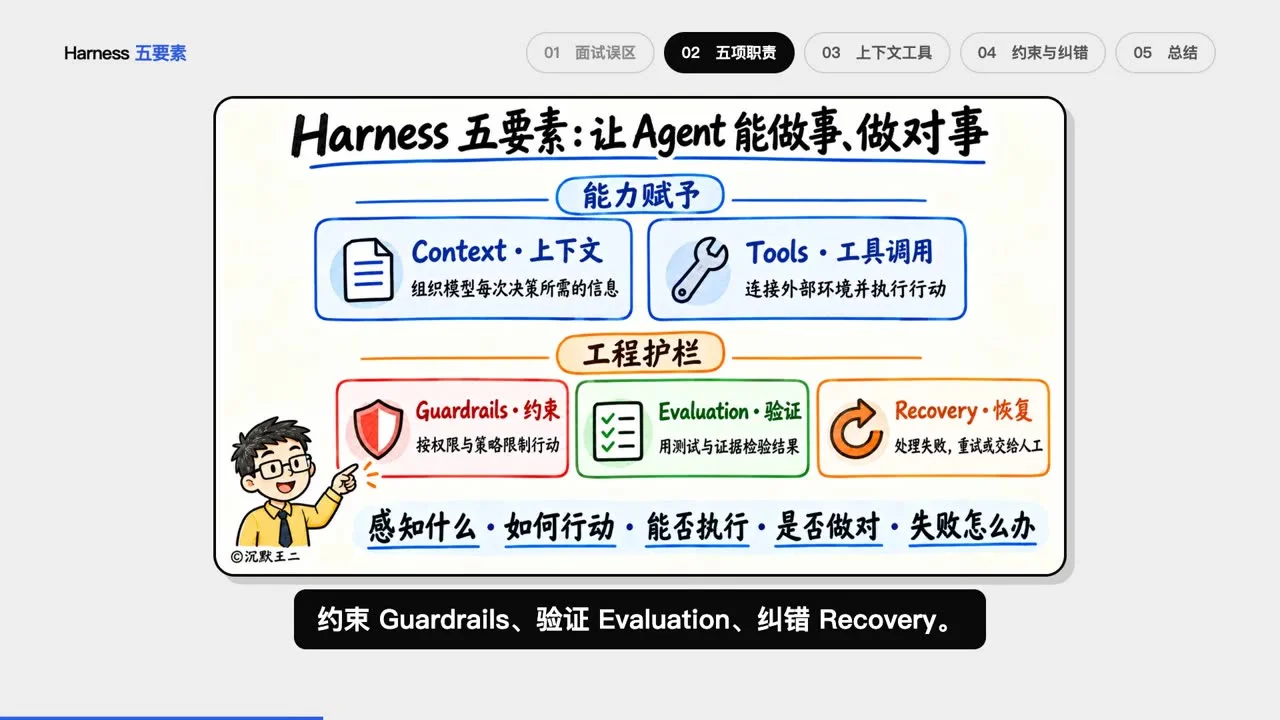
3. 五要素总览
| 要素 | 英文 | 核心问题 | 类别 |
|---|---|---|---|
| 上下文 | Context | 感知什么 | 能力赋予 |
| 工具调用 | Tools | 如何行动 | 能力赋予 |
| 约束 | Guardrails | 能否执行 | 工程护栏 |
| 验证 | Evaluation | 是否做对 | 工程护栏 |
| 纠错 | Recovery | 失败怎么办 | 工程护栏 |
让 Agent 能做事、做对事。前两项赋予能力,后三项是不出事的护栏。
4. 逐项拆解五要素
4.1 Context(上下文管理):让模型看到高质量信息
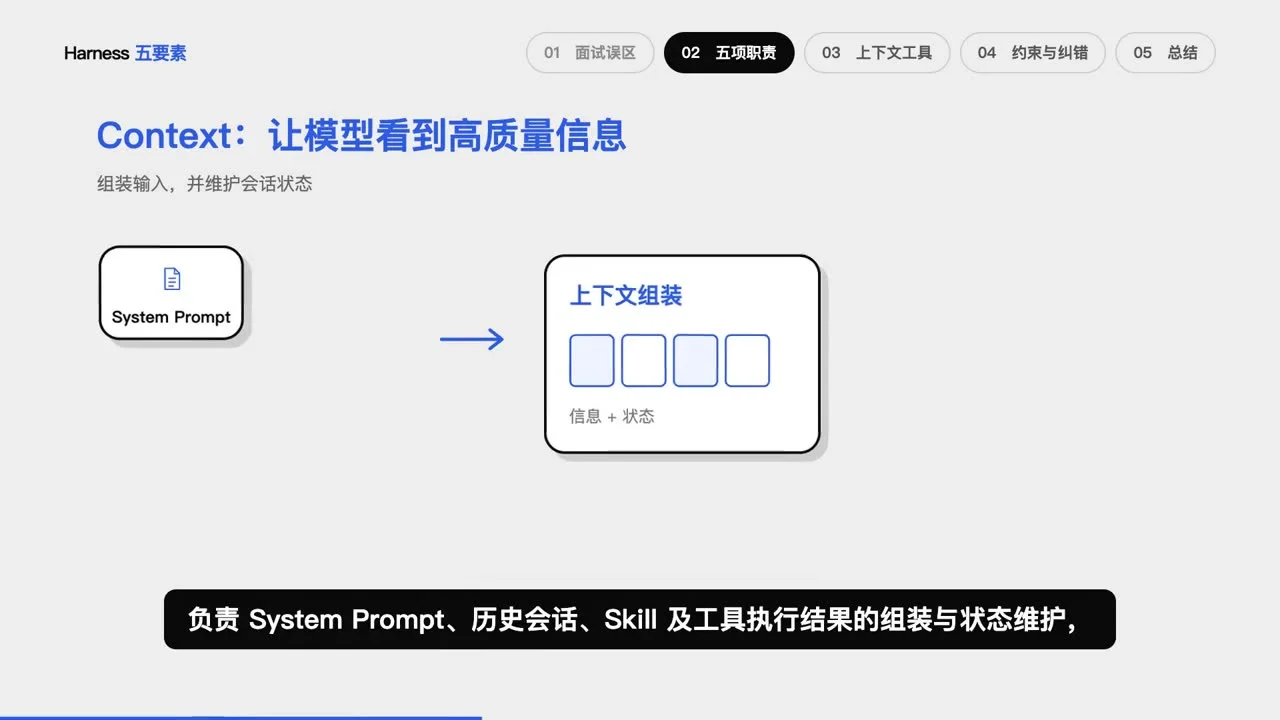
- 负责 System Prompt、历史会话、Skill 及工具执行结果的组装与状态维护。
- 核心目标:让模型每次决策时看到的都是高质量信息。
4.2 Tools(工具调用):把行动接到外部环境
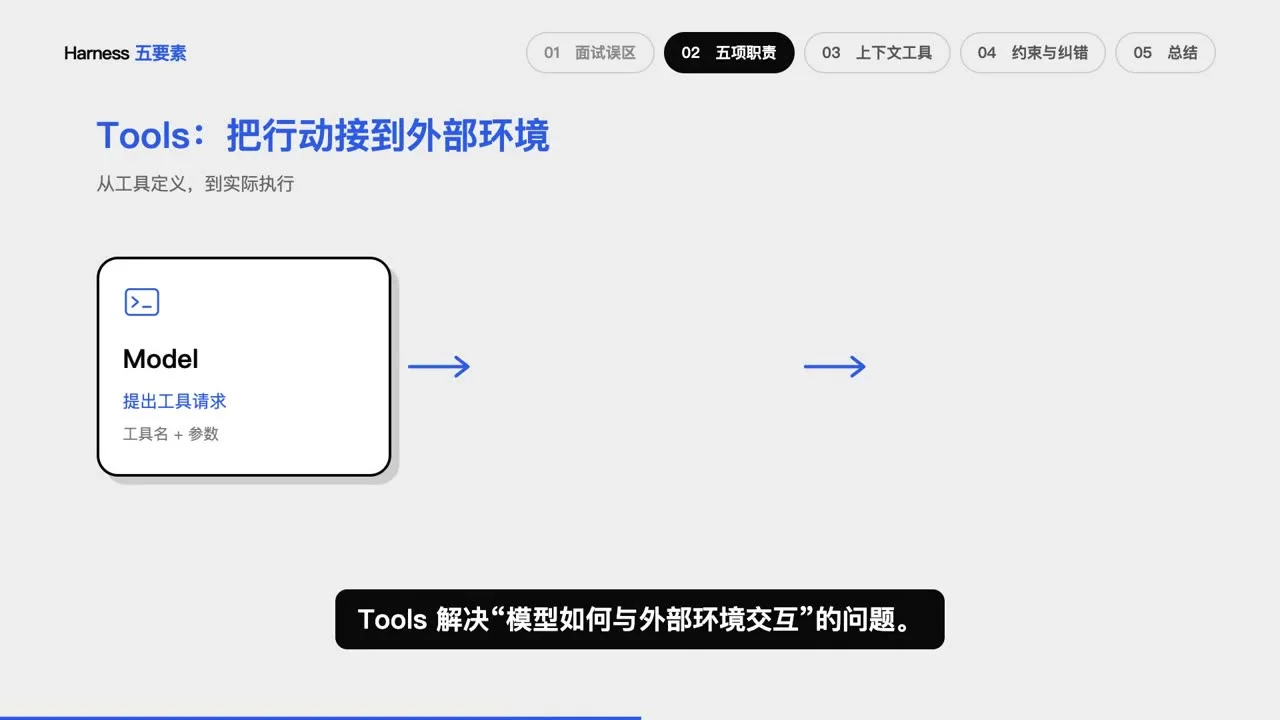
- 解决”模型如何与外部环境交互”的问题。
- 职责:工具注册、定义 JSON Schema、MCP 协议适配、具体执行。
4.3 Guardrails(约束):行动先过权限检查
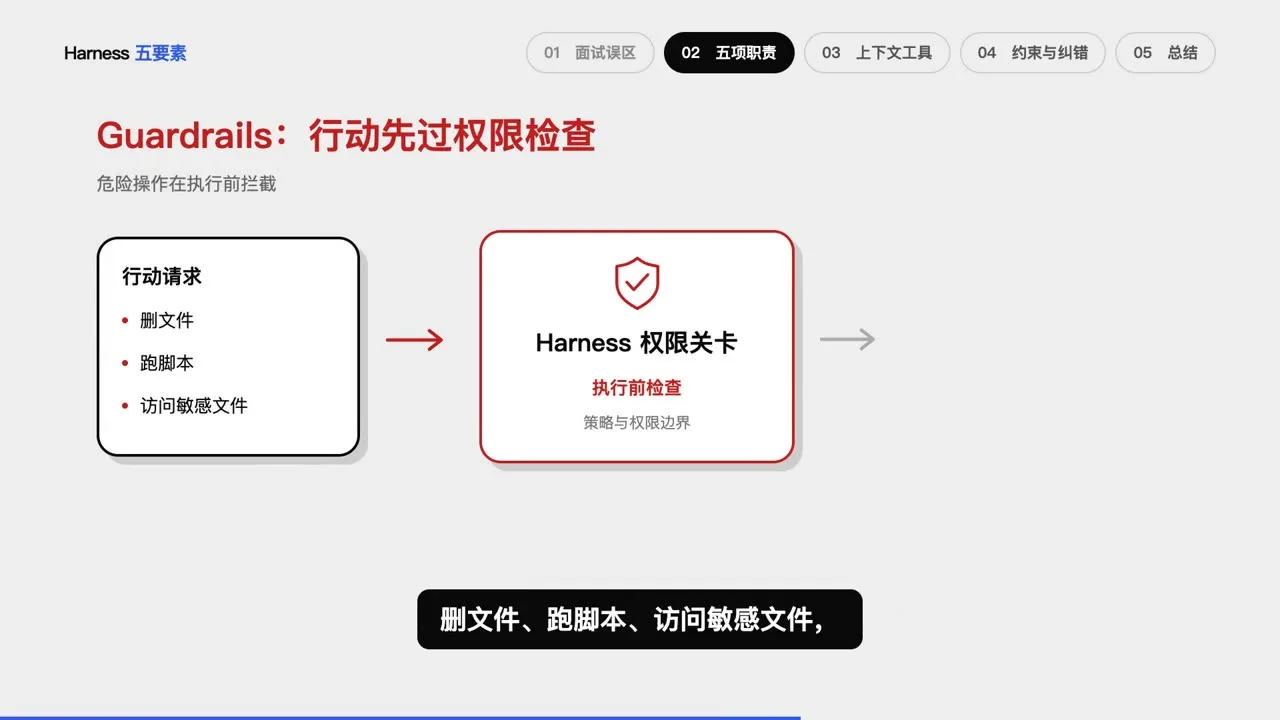
- 限制模型不能做什么:删文件、跑脚本、访问敏感文件等高危操作必须拦截,防止模型失控、越权、产生不可逆破坏。
- 高危操作必须触发 HITL(人机协同审批)。
- 判定逻辑必须硬编码在 Harness 层——不能交给极易受提示词注入影响的模型自身。
4.4 Evaluation(验证):用外部证据检验结果
- 解决”如何客观判断模型做对了没有”。
- 不能盲目信任模型自述”任务已完成”。
- 必须引入外部的确定性反馈。
4.5 Recovery(纠错):出错之后怎么恢复
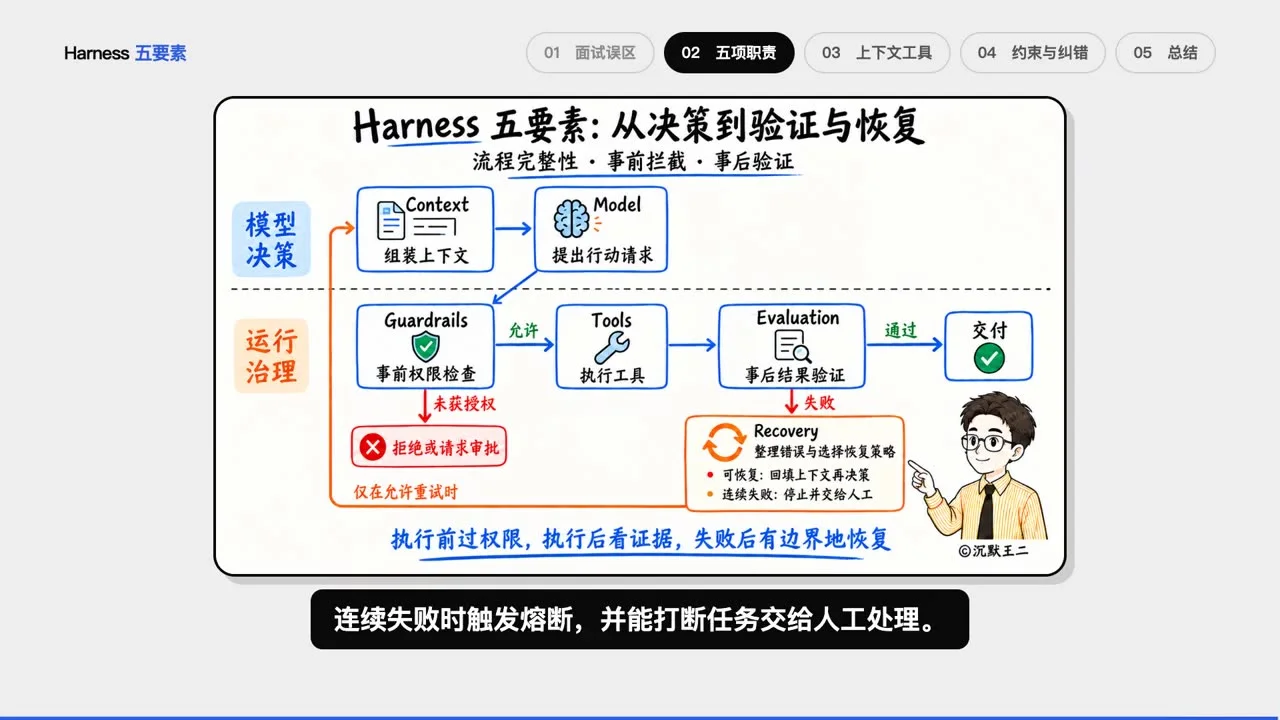
- 带着报错信息让模型反思后重试。
- 连续失败时触发熔断,可打断任务交给人工处理。
5. 工程落地 ①:Context 管理(Claude Code 五阶段)
上下文越来越长,发送给模型之前依次经过五个阶段:
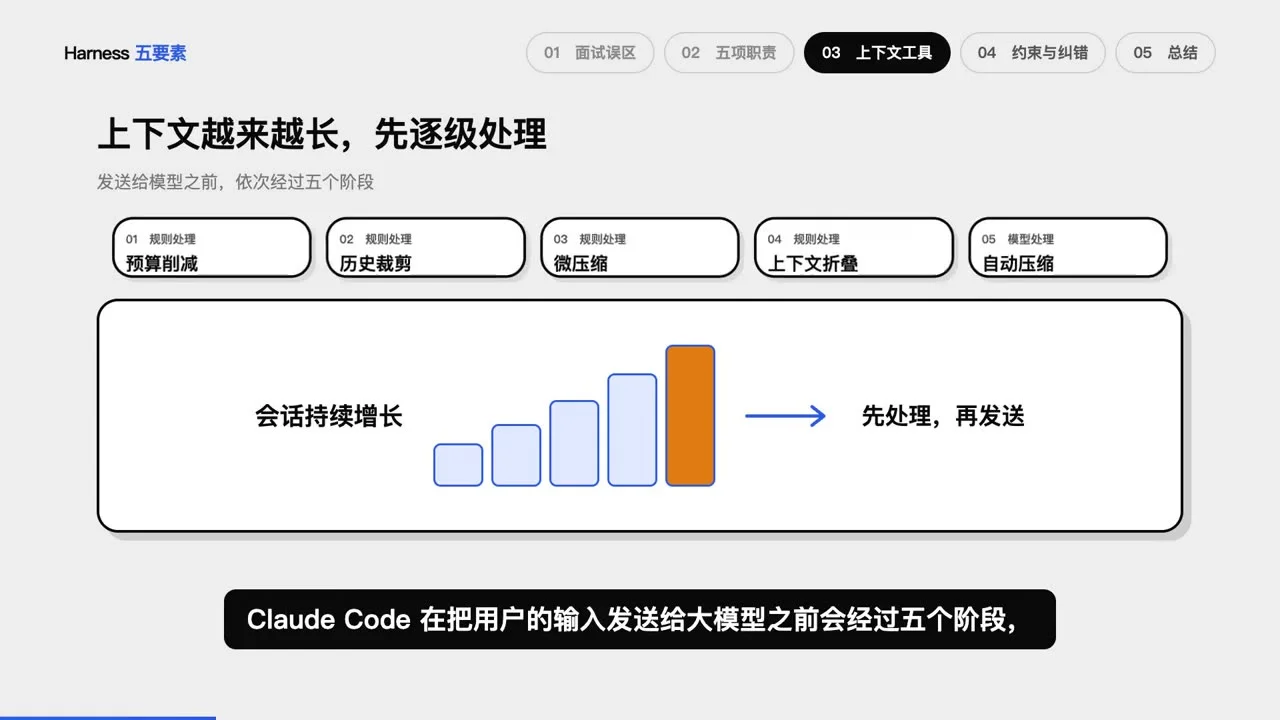
- 预算削减:给单条消息里的工具结果设大小上限。
- 历史裁剪:把过旧、无用的对话直接删掉(确定性规则)。
- 微压缩:专门清理较旧的工具结果。
- 上下文折叠:做读取时的虚拟投影。
- 自动压缩:让 LLM 生成摘要(唯一调用模型的阶段)。
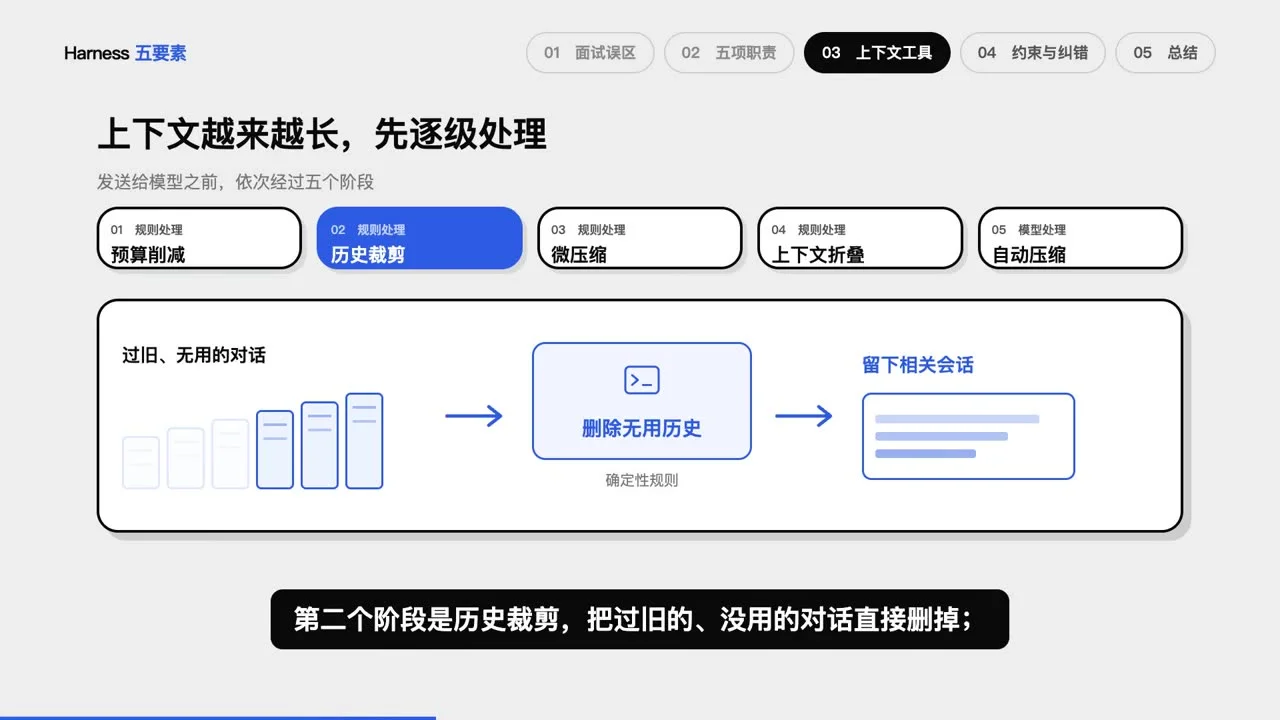
- 为什么不在第 1 步就让模型总结? 因为 LLM 生成摘要要花 Token,而且是有损压缩。
- 原则:能用规则解决的就不要碰模型——前四个阶段是确定性规则,只有最后才调 LLM。
预防的输出问题:工具输出直接把上下文撑爆。比如
git log输出几万行,全塞进上下文,系统指令和会话历史的权重就被噪音淹没。超长输出必须有截断机制,保证工具结果不会把关键信息挤出上下文。
6. 工程落地 ②③④:Guardrails / Evaluation / Recovery 的隔离设计
6.1 Guardrails:独立分类器(Claude Code 七种权限模式)
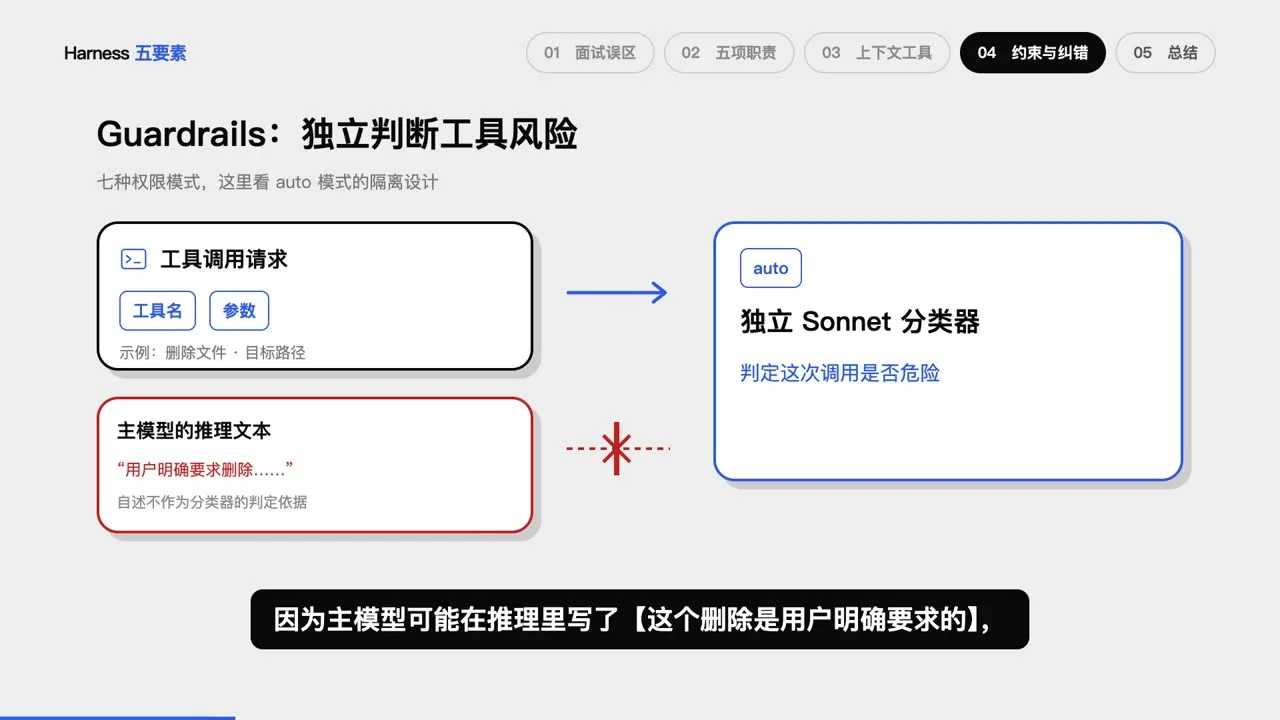
- Auto 模式下启动一个独立 Sonnet 分类器,判定每次工具调用是否危险。
- 分类器只看工具名和参数,看不到主模型的推理文本。
- 原因:主模型可能在推理里写”这个删除是用户明确要求的”,从而诱导分类器放行——所以隔离视图,不被主模型推理干扰。
6.2 Evaluation:只认客观物证
- 判断依据来自执行结果,而不是模型的”确信程度”。
- 编译器的状态码、语法树差异、单元测试断言……模型说”代码已修复”没用,必须跑一遍全量测试才算。
- 因为模型自我评估可能被提示词注入操纵,也可能产生幻觉。
- Claude Code 有 27 个钩子事件(Hooks)可插装验证逻辑,例如工具执行完先经过 PostToolUse 钩子才允许收尾。
6.3 Recovery:先让模型看到真相(清洗报错堆栈)
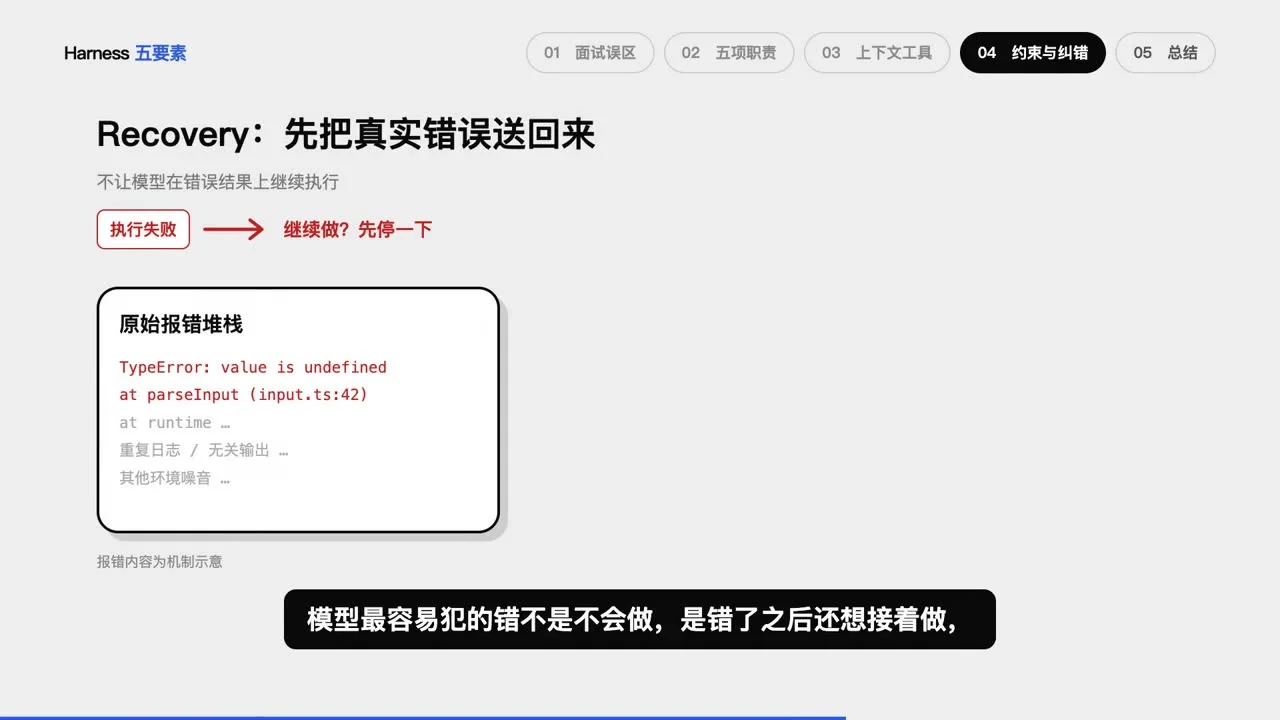
模型最容易犯的错:不是不会做,是错了之后还想接着做。
- Recovery 第一件事:让模型必须看到真相。
- Claude Code 会把报错堆栈清洗一遍再回填上下文——只留能定位问题的信息(如
TypeError: value is undefined at parseInput(input.ts:42)),去掉重复日志、无关输出等噪音。 - 真到 Token 上限:逐级放宽限制重试,每轮最多三次;上下文吃紧先做一次上下文折叠再压缩;仍不行就终止。
7. 源码结论:生产级 Agent 工程占多少
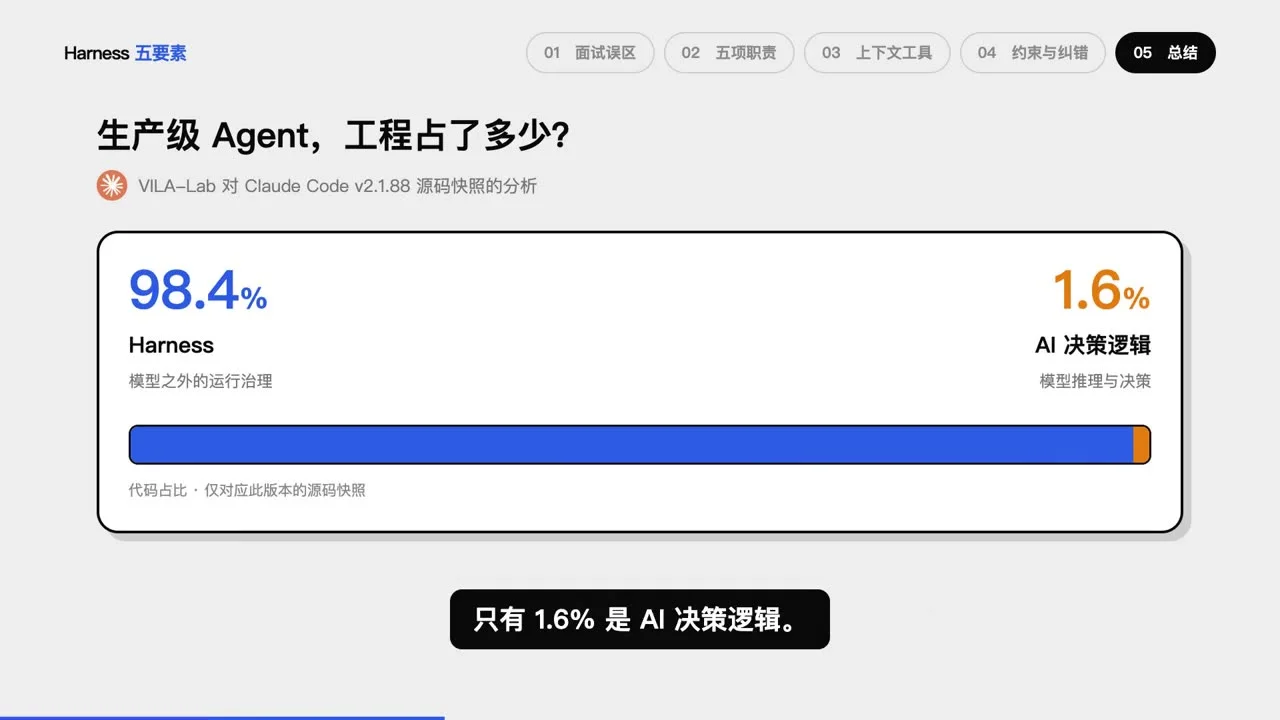
- VILA-Lab 分析 Claude Code v2.1.88 源码快照得出暴论:
- 98.4% 的代码在做 Harness(模型之外的运行治理)
- 1.6% 是 AI 决策逻辑(模型推理与决策)
- 结论:生产级 Agent 的核心,在模型之外的运行治理环境。
8. 面试答题模板(总结页)
- Context · Tools:Harness 最基本的两项要素(能力赋予)。
- Guardrails · Evaluation · Recovery:Harness 的安全边界(工程护栏)。
- 回答公式:“五要素是 Context、Tools、Guardrails、Evaluation、Recovery。前两项管能不能做事,后三项管能不能做错事、做错了怎么办——Memory 和 Planning 是能力维度,不是工程要素。“
9. 完整逐字稿(带时间戳)
-
00:00–01:00 面试官问你 Harness 的5要素是什么?除了 Context 和 Tool Use,你还知道哪些?如果你回答还有 Memory 和 Planning 吧,或者不就这两样吗?恭喜你出门右拐回家等通知吧。为什么?因为 Memory 和 Planning 是 Agent 的能力维度,它们在 Harness 的落脚点是 Context 和工作模式。Memory 最终是以上下文的形式进模型的,Planning 只是一种计划模式,负责规划后再执行任务。真正让生产级 Agent 稳定运行的是另外三项约束:Guardrails、Evaluation、Recovery。我翻 Claude Code 的源码、分析论文和李博杰《深入理解 AI Agent》(需要 PDF 的可以找我),我可以自信地、大方地、光明磊落地帮你搞清楚这三件事:第一,Harness 是什么、五要素分别是什么;第二,五个要素各管什么事、解决了什么问题;第三,工程上怎么落地、生产级代码是怎么实现的。先说第一件事:Agent = Model + Harness,Model 负责推理,Harness 是模型之外 Agent 的运行治理环境。Harness 本意是马具……大模型就像爆发。
-
01:00–01:10 极强的野马。给它套上缰绳和马鞍,才能在受控的轨道上全速奔跑。五要素分别对应:上下文管理 Context、工具调用 Tools、约束 Guardrails、验证 Evaluation、纠错 Recovery。
-
01:10–01:20 前两项管能不能做事?后三项管能不能做错事、做错了怎么办?那聪明的你肯定要问,这5个要素各管什么事?Context 管模型能感知什么。
-
01:20–01:30 负责 System Prompt、历史会话、Skill 及工具执行结果的组装与状态维护。核心目标是让模型每次决策时看到的都是高质量的信息。Tools 解决模型如何与外部环境交互的问题。
-
01:30–01:40 负责工具的注册,定义 JSON Schema、MCP 协议适配和具体的执行。Guardrails 限制模型不能做什么。
-
01:40–01:50 删文件、跑脚本、访问敏感文件这些高危操作必须要有拦截能力,防止模型失控、越权或者产生不可逆的破坏。
-
01:50–02:00 而且高危操作必须要触发 HITL 人机协同审批,且判定逻辑必须硬编码在 Harness 层,不能交给容易受提示词注入影响的模型自身。Evaluation 解决如何客观判断模型做对了没有的问题,不能盲目信任模型自称的任务已完成。
-
02:00–02:10 必须引入外部的确定性反馈。Recovery 管模型做错了怎么恢复,带着报错信息让模型反思后重试。连续失败时触发熔断,并能打断任务、交给人工处理。
-
02:10–02:20 那聪明的你肯定又要问了:工程上怎么落地,真实代码怎么实现。拿 Claude Code 来举例。
-
02:20–02:30 Context 要解决的是上下文越来越长怎么办。Claude Code 在把用户的输入发送给大模型之前,会经过5个阶段:第一个阶段是预算削减,给单条消息里的工具结果设一个大小上限;第二个阶段是历史裁剪。
-
02:30–02:40 把过旧的、没用的对话直接删掉;第三个阶段是微压缩,专门清理较旧的工具结果;第四个阶段是上下文折叠,做读取时的虚拟投影;第五个阶段才是自动压缩。
-
02:40–02:50 让模型生成摘要。前四个阶段是确定性的规则,只有最后一个阶段才会调用 LLM。之所以不直接让模型总结,是因为 LLM 生成摘要本身就要花 Token。
-
02:50–03:00 而且是有损的。能用规则解决的就不要碰模型(兔 th→Tool use)。要预防的是输出直接把上下文撑爆,比如让 Claude Code 跑一条 git log,输出可能几万行,全塞进上下文。
-
03:00–03:10 系统指令和会话历史的权重就被噪音淹没了。超长的输出一定要有截断机制,保证工具结果不会把关键信息挤出上下文。
-
03:10–03:20 对于 Guardrails,Claude Code 有 7 种权限模式。auto 模式下会启动一个独立 Sonnet 分类器,判定每次工具调用是否危险。这个分类器看不到主模型的推理文本。
-
03:20–03:30 因为主模型可能在推理里写了”这个删除是用户明确要求的”,从而诱导分类器放行。分类器只看工具名和参数,这样就不会被主模型的推理干扰。Evaluation 的原则是只认客观物证。
-
03:30–03:40 编译器的状态码、语法树的差异、单元测试的断言等等。模型说”代码已修复”是没用的,必须跑一遍全量测试才算。因为模型的自我评估可能会被提示词注入操纵。
-
03:40–03:50 也可能就是产生幻觉了。Claude Code 有 27 个钩子事件,Hooks 可以插装验证逻辑,比如工具执行完先经过 PostToolUse 钩子才允许收尾。模型最容易犯的错,不是不会做,是错了之后还想接着做。
-
03:50–04:11 所以 Recovery 干的第一件事,是让模型必须看到真相。Claude Code 会把报错的堆栈清洗一遍,再回填上下文,只留能定位问题的信息、不带噪音。真到了 Token 输出的上限,它会逐级放宽限制重试,每轮最多三次;上下文吃紧先做一次上下文折叠再压缩;如果还不行就终止。VILA-Lab 曾分析过 Claude Code V2.1.88 的源码快照,给出这样一个暴论:在 Claude Code 中 98.4% 的代码都是在做 Harness,只有 1.6% 是 AI 决策逻辑。
-
04:11–04:30 最后简单总结下:Context 和 Tools 是 Harness 最基本的两项要素,Guardrails、Evaluation、Recovery 是 Harness 的安全边界。这个知识点,你学会了吗?想解锁更多 Agent 硬核知识,点赞关注,我是二哥,咱们下期见。
10. 幻灯片 OCR 原文速查(VILA-Lab / 图片页面全文字)
- 五要素定位:能力赋予 → Context 组织每次决策所需信息、Tools 连接外部环境并执行行动;工程护栏 → Guardrails 按权限与策略限制行动、Evaluation 用测试与证据检验结果、Recovery 处理失败(重试或交人工)。
- 上下文五阶段:预算削减(限制工具结果大小)→ 历史裁剪(删过旧对话)→ 微压缩(清理旧工具结果)→ 上下文折叠(读取时虚拟投影)→ 自动压缩(LLM 生成摘要,消耗 Token、内容有损)。
- Guardrails Auto 模式:独立 Sonnet 分类器只看工具名和参数,不读主模型推理文本(防”这个删除是用户明确要求的”诱导)。高危操作触发 HITL 审批,判定逻辑硬编码在 Harness 层。
- Evaluation 物证:编译器状态码、语法树差异、单元测试断言;“代码已修复”须跑全量测试验收,判断依据来自执行结果而非模型确信程度。
- Recovery 清洗:报错堆栈清洗后回填上下文,只留可定位信息(如
TypeError: value is undefined at parseInput(input.ts:42)),去噪音;Token 爆时逐级放宽重试(每轮≤3 次),再不行终止。 - 工程占比:Claude Code v2.1.88 源码快照——98.4% 代码做 Harness,1.6% 是 AI 决策逻辑。
完整原始转录(逐字稿 + 全部幻灯片 OCR 快照)保留在桌面
7686445668923231538.md,本笔记为整理版并附视频画面配图。
源 HTML 已归档至 打开交互图。
相关笔记
- 12种 Agent Harness 设计模式 — Harness 的 12 种设计模式(记忆/工作流/工具/自动化四大类)
- Claude Code 架构深度拆解:从一个 AI 编程工具到完整的 Agent Runtime 框架 — 源码级 Runtime 拆解(四级压缩 / 七层恢复)
- 生产级Agent工程架构蓝图(从Demo到千万级并发) — 六层架构 · 状态机闭环 · 工具防弹衣
- Anthropic-Agent产品设计新范式 — Harness 把关工具 / 上下文分层
- Agent Hook-智能体指令约束技术指南(100%稳定与安全) — Guardrails 侧的 Hook 强制约束
- AI 大模型 MOC — Agent 主题内容地图