生产级 Agent 工程架构蓝图(从 Demo 到千万级并发)
一句话总结
把 Agent 从演示用 Demo 变成高并发、高可用的生产系统,难点在底层工程架构(状态机闭环、记忆分级、工具防弹衣、高并发资源隔离),而非 Prompt 技巧。本笔记整合一份 14 页参考架构 PPT 与一张「从 Demo 到生产级的 10 大核心挑战」图解。
原始素材
- 图解(十大挑战总览):
- 原版 PPT 出处:「大厂 Agent 系统架构与工程落地 · 十连问核心解密」
- 原版 PDF 已归档:> [!warning] PDF 暂未发布
原文件Production_Agent_Engineering_Blueprint.pdf约 15.7 MB,超过发布阈值;可在本地 Obsidian 中查看。(14 页 · Gemini Notebook 参考架构 · SENIOR 级)
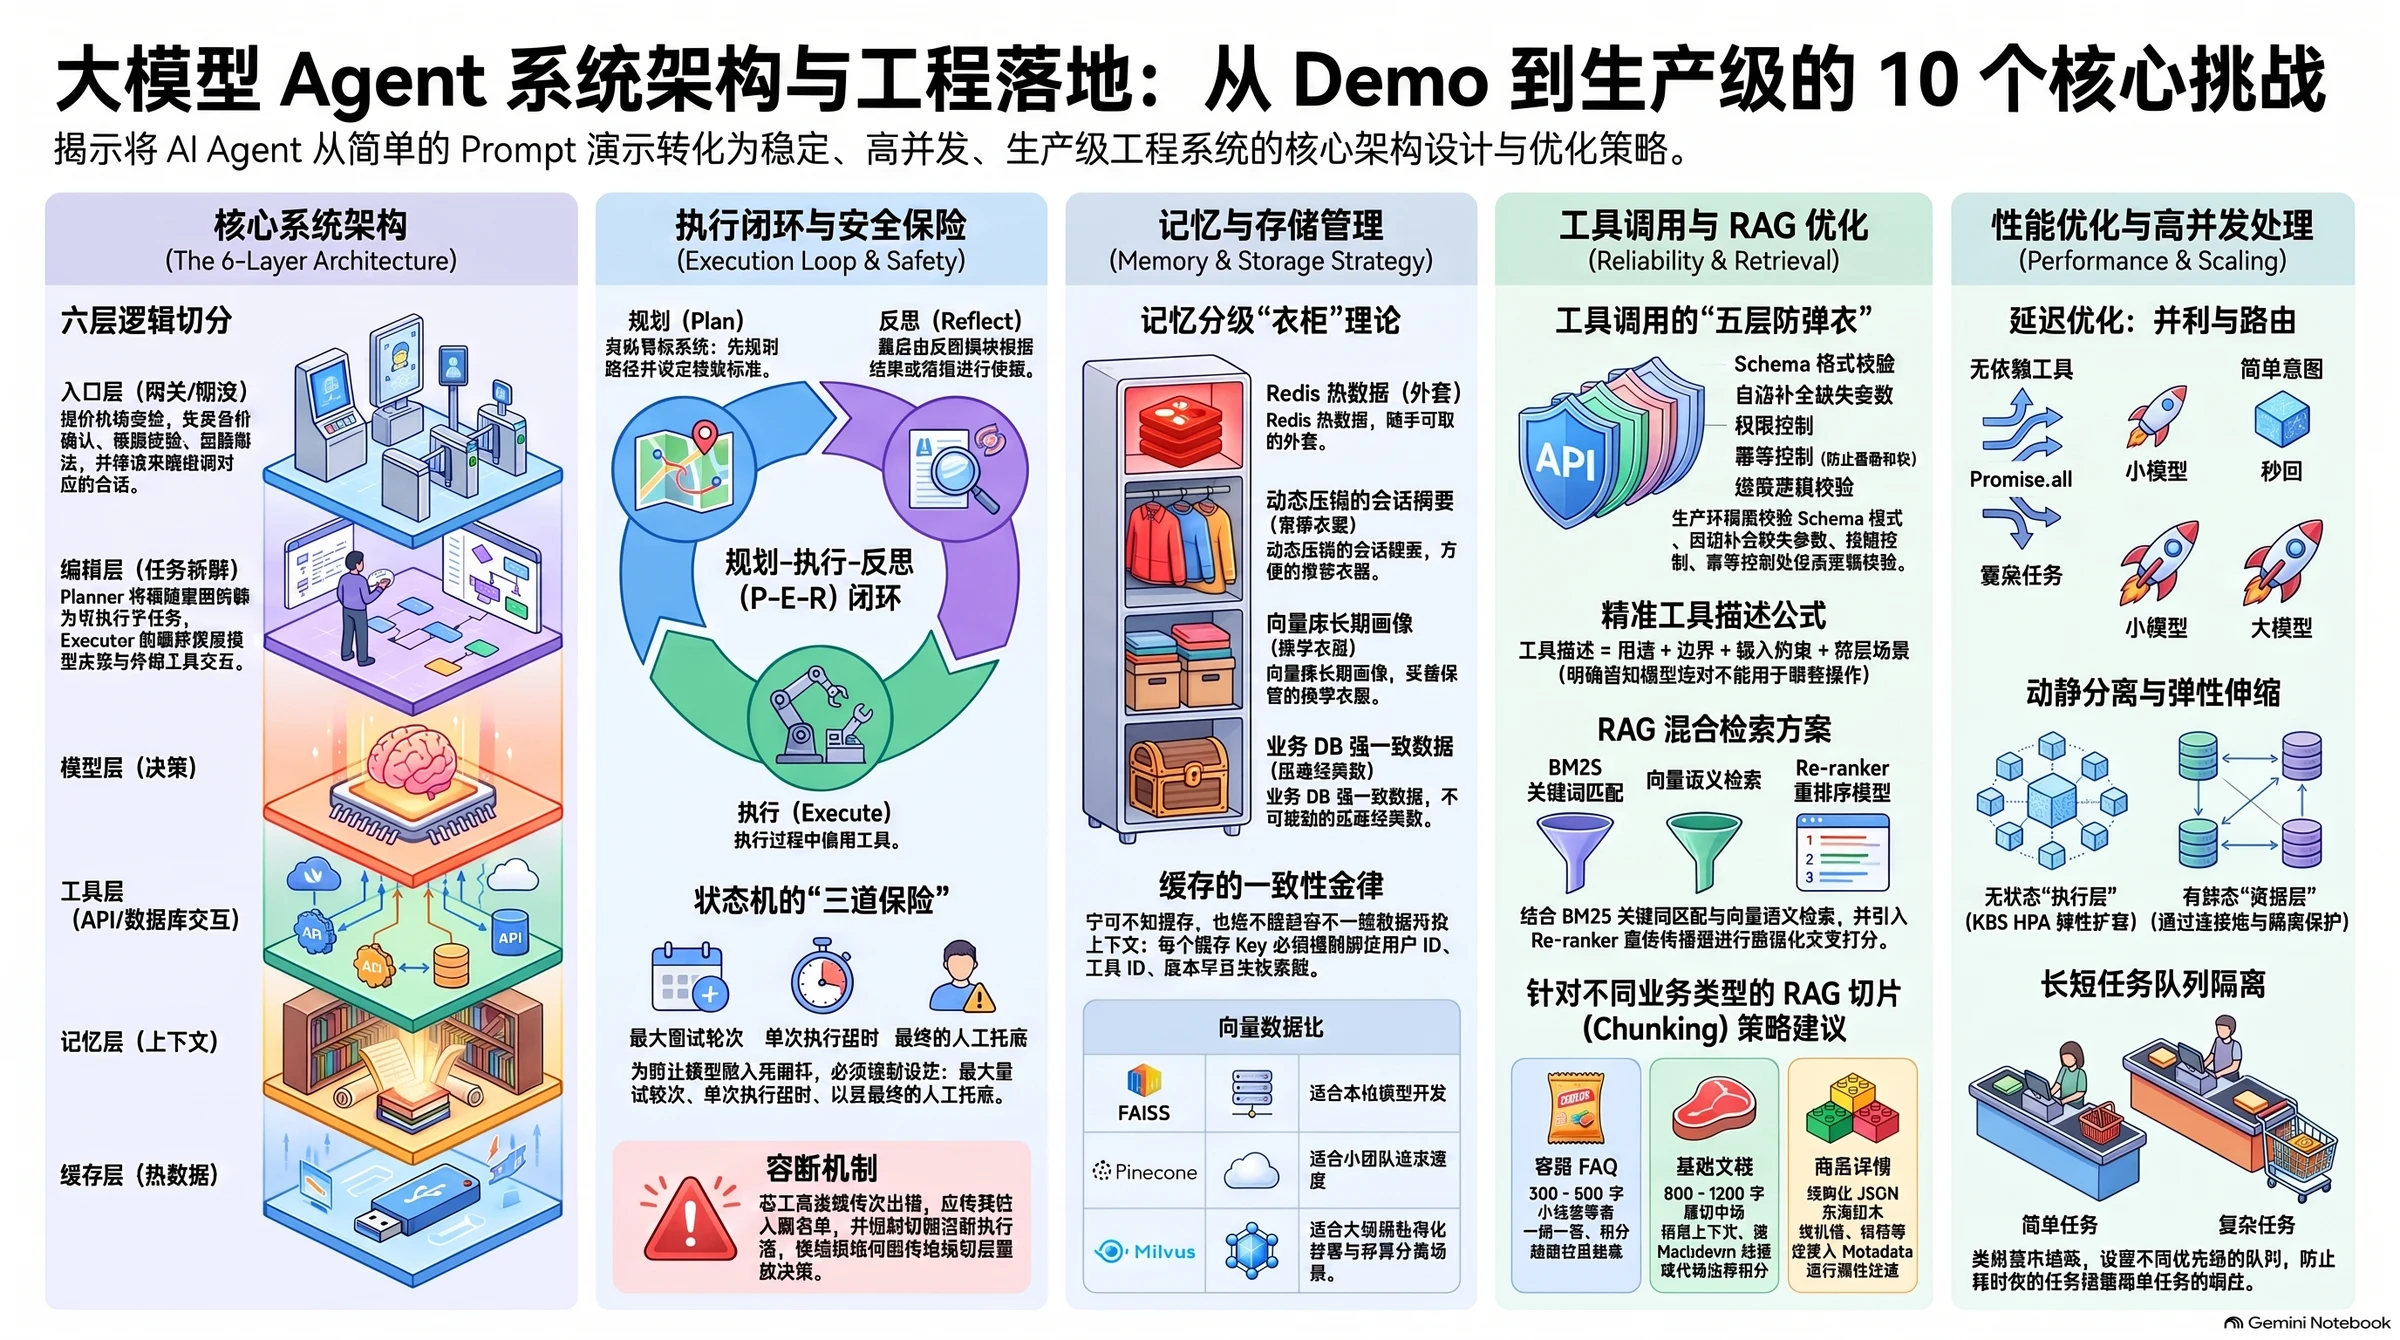
0. 认知升级:面试官真正在意什么
生产环境根本不关心模型有多聪明,只关心系统有多稳。告别花哨的 Prompt 技巧,直面底层工程架构挑战。
| ❌ 玩具级 Demo(脆弱/单点/不可控) | ✅ 生产级 Agent(闭环/容错/高并发) |
|---|---|
| 直接将全量上下文塞入大模型 | 精细化的状态机与缓存分级管理 |
| 依赖单次 Prompt 的运气 | 存算分离与长短任务隔离 |
| 第三方 API 卡死即全盘崩溃 | 多轮校验、兜底与熔断机制 |
| 并发一高系统直接熔断 | P95/P99 延迟的极致并行优化 |
Quote
把 Agent 从演示 Demo 变成高并发、高可用系统,难点在底层架构,而非 Prompt。
1. 六层逻辑架构(核心系统解剖)
像机场安检一样分层切分,从下到上:
| 层 | 职责 | 类比 |
|---|---|---|
| 入口层 Gateway | 身份确认、鉴权、防刷限流、路由至对应会话 | 机场安检/闸机 |
| 编排层 Orchestrator | 将模糊意图拆解为可执行的子任务(Task DAG) | 任务拆解 |
| 模型层 Model | 核心决策推理,基于子任务思考与调度 | 大脑 |
| 工具层 Tools | 外部环境交互:数据库查询、API 调用 | API/数据库 |
| 记忆层 Memory | 实时读写多轮对话上下文,维持状态连贯 | 上下文 |
| 缓存层 Cache | 高频热数据存储,避免重复计算、极速响应 | 热数据 |
完整链路
User Request → 入口网关(鉴权限流)→ 编排层(拆任务)→ 模型层(决策)→ 工具/记忆/缓存 → 安全审核聚合 → 最终响应返回。
2. 执行闭环与三道保险(编排 + 模型层)
Plan-Execute-Reflect(规划-执行-反思)不是文字游戏,而是严格的代码状态机控制。
防死循环的工程防线(三道保险):
- 最大重试轮次:达到上限立即终止,防止无限消耗 Token。
- 单次超时限制:斩断长时间卡死的第三方工具调用。
- 人工兜底机制:核心链路异常,自动降级转交人工。
容断机制
若模型连续出错(连错 2 次),切断当前执行,将错误堆栈喂给 Plan 层强制重新决策,而非原地打转。
3. 记忆分级与缓存策略(记忆 + 缓存层)
记忆不是越长越好,而是越有条理越好——管理记忆如同整理衣柜。
| 记忆层级 | 存储介质 | 说明 |
|---|---|---|
| 短期上下文(外套) | Redis | 会话级热数据,直接存取、极速响应 |
| 会话摘要(常穿衣服) | 动态压缩 | 提取对话主线,丢弃冗余细节 |
| 长期用户画像(珍藏款) | Vector DB | 按需语义召回 |
| 业务知识库(经典款) | 关系型数据库 | 强一致数据,必修进业务 DB |
缓存黄金定律:缓存乱了比没缓存更可怕
- 必须强制绑定:
User_ID + Session_ID + Tool_ID - 所有 Key 必须带 TTL 与失效策略
- 原则:宁可不加缓存,绝不容忍脏数据污染业务
向量库选型矩阵(场景决定技术栈):
| 方案 | 适用场景 | 瓶颈/优势 |
|---|---|---|
| Chroma(轻量型) | 本地原型开发 | 数据量一大查询极慢 |
| Pinecone(SaaS型) | 团队小步快跑 | 规模化后成本极高、数据不在手 |
| Milvus(重卡型) | 淘宝级大规模导购/客服 | 云原生/存算分离/私有化,强 Metadata 过滤 |
淘宝级落地经验
大规模复杂业务中,纯向量相似度检索远远不够。必须选支持存算分离 + 强大 Metadata 过滤的系统,把商品类目、价格等业务数据融入检索。
4. 工具调用的可靠性防线(不要盲信模型)
五层拦截「防弹衣」(输入校验):
- Schema 校验:参数格式是否完全匹配
- 参数补齐:缺失值自动补默认值
- 权限校验:严禁越权调用敏感 API
- 幂等控制:防止重复下单/扣款
- 结果校验:工具返回数据是否合乎逻辑
四步熔断机制(异常处理):
- 失败计数:连错 2 次,立即拉入黑名单
- 强制切断:中断当前执行,错误堆栈喂给 Plan 层强制重塑
- 规则化兜底:剥夺模型自由发挥权,输出预设话术
- 转交人工:涉及核心交易,宁可降级绝不空耗 Token
工具描述编写公式(边界画得越清,越界越少):
Tool_Definition = {
  Purpose      用途:何时调用
  Boundary     边界:处理范围
  Constraints  约束:参数的严格格式
  Taboos       禁忌:【强烈否定词】绝对不要用于 XXX
}
实战案例(淘宝库存查询):明确「用途=查某地区某商品是否有货」「约束=必须提供数字 item_ID + 国标省市区 region_code」「禁忌=不要用于查价格/优惠券/店铺搜索,查价请调 query_price」。
5. RAG 分块定制化与检索相关性(工程化的检索优化)
分块没有银弹,切分大小取决于语义完整性与召回精度:
| 业务 | 策略 | 要点 |
|---|---|---|
| 客服 FAQ(小包装零食) | 300-500 字 | 精准一问一答,切忌多个 QA 糅合进同一 Chunk |
| 基础文档(厚切牛排) | 800-1200 字 | 保留上下文,严格按标题/代码块边界切分,绝不从代码中间截断 |
| 商品详情(乐高积木) | 结构化 JSON Metadata | 放弃纯文本切分,把价格/材质等属性独立存为 Meta |
检索相关性「四套组合拳」:
- 查询改写 Query Rewrite:小模型预处理口语化输入(例:苹果手机 → iPhone)
- 混合检索 Hybrid Search:BM25(关键词精准)+ Vector(语义泛化)双管齐下
- 重排序 Reranker:粗排召回前 50,专门模型交叉打分压至头部
- 业务特征硬过滤 Hard Filter:类目、价格、库存等 Metadata 作为硬性前置过滤,一票否决
关键
纯靠向量相似度检索等于开盲盒。生产环境必须走「改写 → 混合检索 → 重排 → Metadata 硬过滤」的组合拳。
6. 高并发与延迟优化(P95/P99:用户要的是快看见)
原则:不追求全算完,追求最快首包响应。
数据与并行策略:
- 并发请求:无依赖的工具坚决用
Promise.all并行发起 - 阻截大模型:高频数据直接查 Redis,不走模型
- 离线预计算:复杂逻辑用定时任务提前离线算好
模型与架构策略:
- 大小模型路由:简单意图小模型秒回,复杂决策大模型上阵
- 流式输出 Streaming:先返回首包,长任务转后台异步
- 超时熔断:必加超时限制,绝不让拖沓的 API 拖死全盘
7. 弹性伸缩:无状态与有状态的彻底剥离
架构师的核心功底,在于容量保护与资源隔离。
- 入口网关(游乐园闸机):承担限流、排队、熔断,把异常流量挡在外部,保护微服务不被冲垮。
- 无状态执行层(弹性伸缩区):只负责逻辑编排、完全不存状态。盯队列长度,用 K8s HPA 极速横向扩容。
- 有状态资源层(队列隔离):瓶颈点在大模型 API 配额、DB 连接池。对策是按不同优先级队列实现长短任务隔离(High/Low Priority Queue)。
Quote
不能让一个只买一瓶水的人,堵死整个超市收银台。
8. 终极全景图(Architecture Synthesis)
浓缩千万级并发 Agent 系统的所有关键节点,可作为生产级系统设计的标准体检表:
- Gateway(Rate Limit / Auth)→ 接入数据总线
- Stateless K8s Pods (HPA) → 弹性扩容,接数据总线
- Memory Bus(Redis → DB → Vector DB)→ 记忆总线
- DATA BUS(数据总线)贯穿所有组件
- Plan-Execute-Reflect(Timeout / Retries)→ 状态机闭环
- Tool Bus(5 层盾牌 / 4 步熔断)→ 工具防线
- RAG Pipeline(Rewrite → Hybrid → Rerank → Metadata 硬过滤)